万字长文解析DeekSeekV4.1flash
万字长文解析DeekSeekV4.1flash
从整体架构图出发,完整串联多模态输入、Causal Encoder–Decoder、CSA2、MoE、Single-Pass mHC、Engram、DSpark、Prefill/Decode、KV Cache 生命周期、Prefix Caching、Bounded Replay、PD 分离和 PD 流水线。
本文是新建的模型架构文档,不覆盖、不修改原有《DeepSeek-V4 CSA/HCA 与 DeepSeek-V4.1 CSA2 详解》。正文以整个模型和请求执行过程为主线;附录完整保留原专题的技术展开,并修正少量表述歧义,避免只保留摘要而丢失公式、代码、例子和比较。
阅读约定与证据边界
- 层号全部采用从零开始的编号:Encoder 为 L0–L19,Decoder 为 L20–L39。报告正文采用的数学层号可能从一开始,不能直接混用。
- 一般注意力公式使用从一开始的 token 位置;讲解缓存区间时明确使用从零开始的半开区间 。半开区间包含 ,不包含 ,长度为 。
- 模型事实来自官方技术报告和配置;参考代码事实只描述公开实现;工程推导描述由依赖关系推出来的可行实现,不冒充官方生产部署细节。
- “所有内容”指前面讨论过的模型、注意力与推理系统主题及追问,不等于翻译整份报告的训练数据、评测和后训练章节。相关训练适配只在影响模型执行语义时展开。
- 公式统一使用 LaTeX。示意代码用于解释控制流,不是可直接运行的生产推理引擎。
- 此前整体架构讲解中的五张 Mermaid 图已按原始图源补回正文,并分别附逐图解释;附录原有十二张 Mermaid 图继续保留,不额外转换为静态图片。正文原有四张附件图片不受影响。
目录
- 第一部分:整个模型如何组成
- 第二部分:请求如何运行
- 第三部分:如何部署和优化
- 附录 A:原 CSA/HCA/CSA2 专题的完整技术展开
- 附录 B:完整性核对清单与来源
1. 整体架构与三种不同的“切分”
1.1 先看整体图
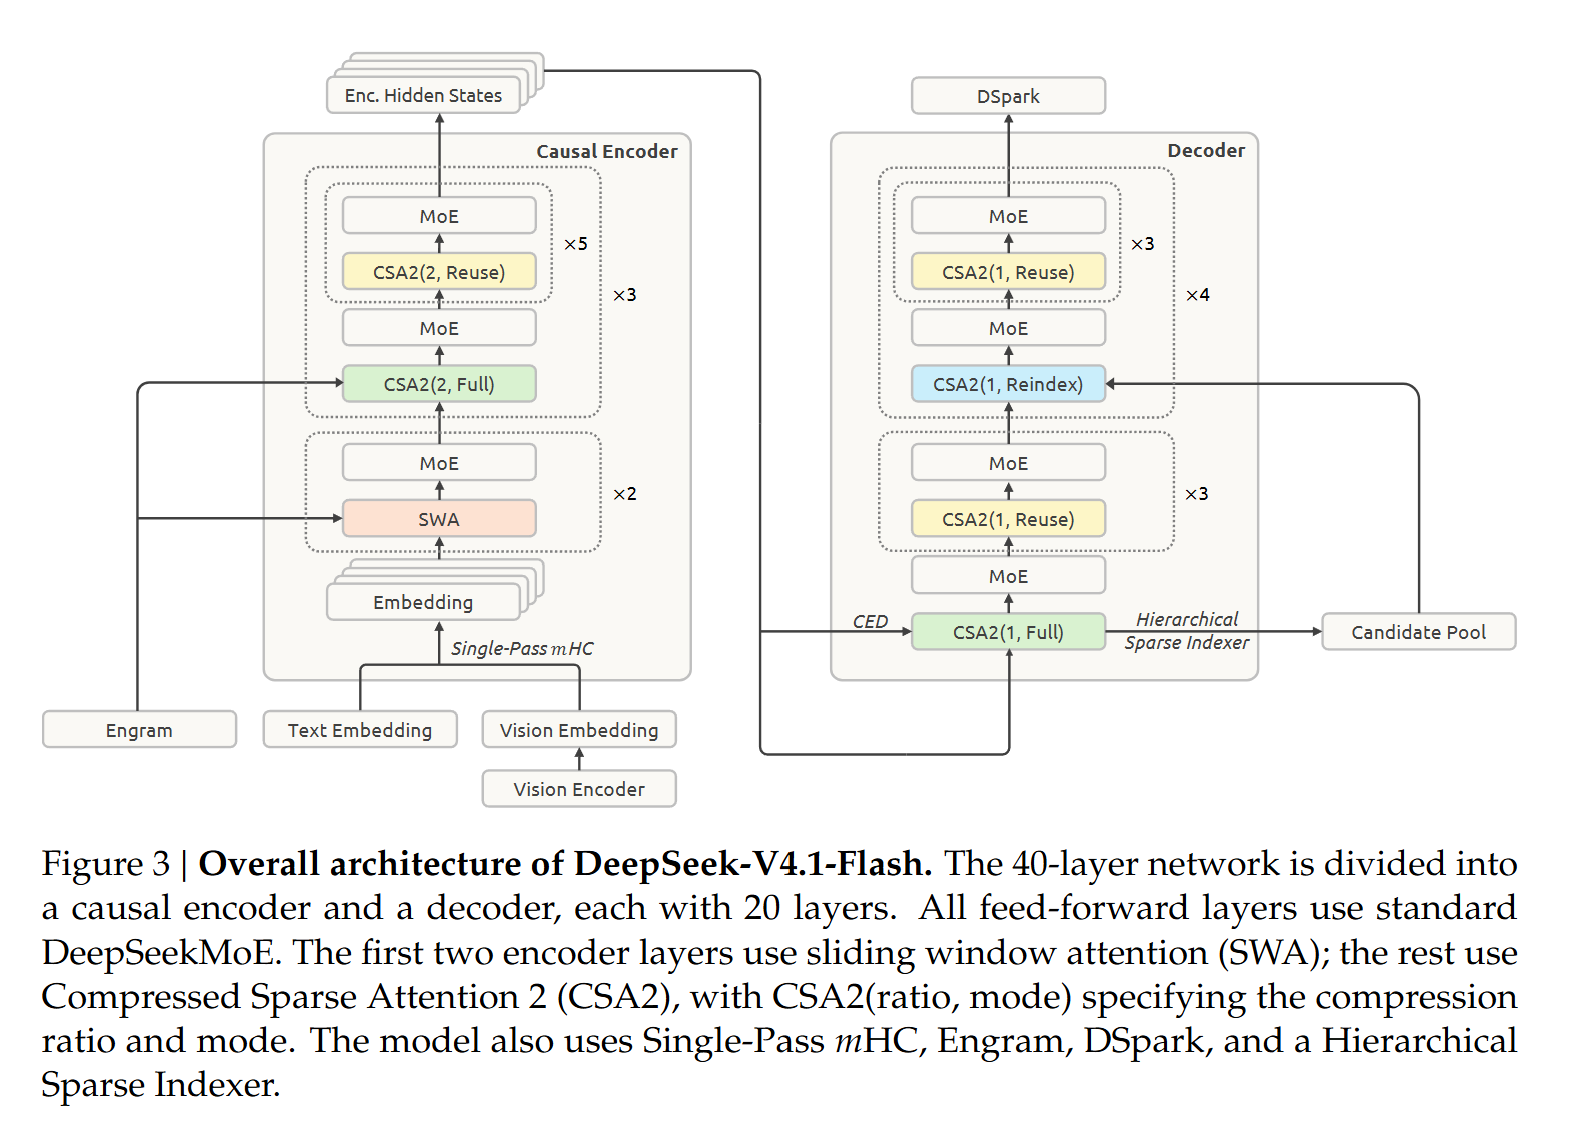
图 1 阅读顺序:先自下而上读左半边,再沿 Encoder Hidden States 的连线进入右半边。 图中大框是模型模块,不是两台服务器;箭头表示张量依赖,不代表必然存在网络传输。
从整张图看,模型由以下部分共同构成:
- 文本 token 经 Text Embedding 进入统一输入序列。
- 图像经 Vision Encoder、空间降采样和 Vision Embedding,转换为同一 hidden dimension 的视觉 token。
- 文本和视觉 embedding 合并后进入 20 层 Causal Encoder。
- Encoder 输出一系列 final hidden states,它们既是 Decoder 的输入,又是 Decoder 共享 Global KV 的生成来源。
- 后面的 20 层 Decoder 在共享 Global KV 上执行不同层的检索和注意力,每层仍有自己的局部 SWA。
- 所有 backbone block 都包含 MoE,并通过 Single-Pass mHC 管理多条 residual stream。
- Engram 在选定的 Encoder 层提供稀疏条件记忆。
- 主模型最终产生语言模型 logits;DSpark 是加速自回归生成的推测解码模块,不是用来替代主模型正确性验证的输出头。
这不是“一个 CSA2 模块加很多外围组件”,而是一次联合设计:CED 降低长输入的深层计算,CSA2 减少长期缓存和重复索引,SWA 保留逐层局部计算深度,低精度缓存降低存储和搬运成本,mHC、MoE、Engram、DSpark 分别优化表示、条件计算、记忆与生成效率。
1.2 第一种切分:模型内部的 Encoder / Decoder
Encoder 是因果的,不是可以双向看到完整输入的 BERT 式 encoder。位置 的表示不能依赖未来 token。
这里的 Decoder 也不是“只有传统 encoder–decoder cross-attention”的模块:它一方面读取 Encoder 生成的全局 memory,另一方面保留由当前 Decoder 层 hidden 生成的局部 SWA。
1.3 第二种切分:推理阶段的 Prefill / Decode
- Prefill:处理已有 prompt,建立后续生成需要的状态,并得到第一个输出 token 的分布。
- Decode:把已采样的新 token 送入模型,继续更新状态并预测下一个 token。
这和前面的两个模型模块不是一一对应关系:
| 推理阶段 | Causal Encoder | Decoder |
|---|---|---|
| 冷 Prefill | 全部 prompt 位置通过 20 层 | Global KV 覆盖全部 prompt;尾部最多 128 个 query 位置通过 20 层 |
| Prefix-hit Prefill | 新 suffix,以及必要的恢复计算 | 建立缺失的 Global KV,重放完整 prompt 尾窗 |
| 普通 Decode | 每个新输入 token 通过 20 层 | 同一 token 再通过 20 层 |
所以“Decoder 机器只跑后 20 层”不是标准 PD 分离。 Decode worker 通常需要执行完整 40 层模型。
1.4 第三种切分:部署上的 E / P / D
图 1A:整体服务架构——请求入口、E/P/D 与三类外部数据
下面补回此前讲解中的整体服务架构图。它表示部署与状态通路,与图 1 的模型层结构是两个不同视角。
逐条读图:
- 请求入口先做文本 tokenization、图像预处理和会话识别。文本可以进入 P;图像需先通过 E 的 Vision Encoder 和 Projector,得到视觉 embeddings 后再进入 P。
- P 不只做矩阵计算,还可能加载已命中的长期 Global prefix 和短期 Encoder SWA。两条缓存路径分开,因为生命周期与缺失恢复成本不同。
- Engram 是共享模型参数表的查表与预取通路,不是某个请求的 prefix KV。它可为 P 和 D 提供计算所需的条件记忆。
- P→D 的箭头表示交接可续跑的请求状态:Global、局部 SWA、压缩尾部以及元数据。哪些对象直接传输、哪些通过缓存引用或目标端重建,见第 14 章。
- D 的普通生成步骤运行完整 40 层,而不是仅图 1 右半边的 20 层。DSpark 可以参与草稿与验证调度。
- 生成中形成的可复用 Global 可进入长期层;可复用的 Encoder SWA 可进入短期池。图中的回写箭头表达对象去向,不表示每输出一个 token 都同步写一次 SSD,也不表示 Decoder SWA 进入 prefix cache。
这张图是依据模型与报告恢复的服务逻辑示意,不规定官方生产集群的精确网络拓扑。
报告采用 EPD disaggregation:
- E:处理视觉编码的部署资源;
- P:处理 Prefill 的部署资源;
- D:处理逐步生成的部署资源。
这里的 E 主要对应 Vision Encoder,不等于 L0–L19 的 Causal Encoder。后文单独分析 EPD 和 PD 的传输、依赖与流水线。依据:报告 §3.2
2. 从输入到输出逐个解释组件
2.1 Text Embedding 与统一序列
设文本 token ID 为 ,embedding table 为 ,则:
文字和图像最终都必须进入同一个序列坐标系。之后的 causal masking、RoPE、压缩块边界和 cache position 都基于这个统一序列,而不是分别维护两个互不相关的语言模型。
Embedding 是模型参数查表;查出来的向量是当前请求的 activation。Embedding table 本身不是请求 KV Cache。
2.2 Vision Encoder 与 Vision Embedding
视觉路径为:
主要配置包括:32 层视觉 Transformer、hidden dimension 为 1024、16 个 attention heads、patch size 为 14。视觉特征经过两层 MLP projector,映射到语言 backbone 的 5120 维。
假设视觉特征网格为:
忽略边界 padding, pixel-unshuffle 将相邻九个位置的特征重排到 channel 维:
因此语言模型接收到的视觉 token 数减少为原来的约九分之一。这不同于 CSA2:视觉降采样在进入语言 backbone 前发生,CSA2 压缩的是模型内部供全局注意力使用的记忆条目。
ViT 使用 2D-RoPE、RMSNorm、SwiGLU,并采用线性 patch projection。生成每一个新文本 token 时,不需要重新把同一张图像跑一次 ViT;图像已经通过 prompt 的表示和后续状态参与生成。多轮请求出现新图像时,才需要处理新增视觉输入。
2.3 MoE:每层都有,但并非每个专家都执行
每个 backbone block 的前馈部分是 DeepSeekMoE:
- 一个 shared expert;
- 384 个 routed experts;
- 每个 token 选择其中六个 routed experts;
- 每个 expert 的 intermediate dimension 为 2304;
- 使用带幅值限制的 SwiGLU,配置阈值为 10。
用示意式表示:
这是语义表达式,实际归一化、路由尺度和激活限制由具体实现决定。
552B backbone 参数不等于每个 token 都执行 552B 参数的运算。 报告给出的有效激活规模是 Prefill 约 8B/token、Decode 约 16B/token;Prefill 的口径来自大部分位置只经过下半模型,不能理解为所有 prompt 位置都严格只使用 8B 参数、完全没有 Decoder 尾窗成本。
系统上应分别考虑:专家权重存储、实际激活专家的矩阵乘、token dispatch/combine 的通信、专家负载不均。采用 Expert Parallelism 时通常会出现专家间 token 传输;具体通信组和拓扑属于部署选择,不能仅从模型图推定。
图像与文字的路由负载为什么分别平衡
图像 token 和文字 token 的特征分布不同,可能偏好不同专家。合在一起“总体均衡”不代表两个模态各自均衡。
V4.1 为两种模态分别维护 expert correction bias。偏置参与专家选择;被选中专家输出的加权仍使用原始 routing scores。它是训练和路由行为设计,不意味着图像、文字必须部署到互不共享的两套专家模型。
2.4 Single-Pass mHC:优化 residual activation,不是 KV Cache
普通 residual connection 维护一条 hidden stream。mHC 在相邻 block 间维护多条 residual streams,V4.1 配置扩展倍数为四。
设:
原始 mHC 的示意更新为:
其中 混合输入流, 变换 residual streams, 将 block 输出分配回多条流。
原实现中的依赖是:先更新 ,再用完整 算系数,得到 后才能混合输入。对 hidden dimension 做全局 reduction 的等待导致多次遍历 activation。
Single-Pass mHC 改为使用前一个 block 预测的输入混合系数:
因为 已经可用,读入当前 residual tile 时,可以同时做输入混合,并累积下一步系数预测所需统计量。生产中的 Mega-mHC 将 residual update、input mixing、coefficient prediction、pre-norm 和 FP8 转换融合。
报告比较的 activation 读写量由原来的:
降到:
这里的“减半”针对这一 residual 处理流程,不是模型所有 HBM 流量减半,也不是 KV Cache 减半。Single-Pass 也不意味着所有 Transformer 层可以一次并行算完。
2.5 Engram:参数化条件记忆,不是历史 KV
Engram 的目标是将一部分记忆能力交给稀疏查表,而非全部依赖 dense/MoE 计算重建。V4.1 在 L1 和 L14 放置两个模块,合计约 196B Engram 参数。
每个模块使用二元、三元、四元 token n-gram,每个阶数有八个 hash heads,总 embedding dimension 为 2048;每个 hash head 对应约 1600 万 entry 的表。不同表大小采用不同素数。
概念流程是:
查表地址只由 token 序列决定,因此可以提前知道。在推理中,可从 host memory 通过后台 RDMA 预取,第一处 Engram 的预取可与第一个 Transformer block 重叠。表和相关 key/value projections 使用 FP8。V4.1 去掉了原 Engram 中的短 causal convolution,以降低推理实现复杂度。
必须分开以下对象:
| 对象 | 内容 | 是否为请求的历史注意力缓存 |
|---|---|---|
| Engram table | 训练得到的模型参数 | 否 |
| Engram lookup activation | 某次查表取得的向量 | 否,是临时 activation |
| Global KV | 当前请求上下文的全局记忆 | 是 |
| SWA KV | 当前请求各层的局部历史状态 | 是 |
Engram host-memory 预取是报告中的部署路径;报告同时说明 RL rollout 中可以让表驻留 GPU。不同运行场景不能混成一个固定的存放规则。
2.6 DSpark:产生草稿,再由主模型验证
DSpark 包含三个 Transformer blocks,局部窗口为 128。一次 drafter forward 为五个草稿位置并行产生 base logits,同时由轻量 Markov head 建模草稿 token 之间的依赖。
因此“五个位置并行”不等于五个 token 完全独立,也不等于每次一定接受五个 token。
Confidence head 预测各位置的条件接受概率,调度器结合当前负载下的 engine throughput profile,动态决定每个请求验证多长的草稿。其目标是系统吞吐,不只是把单个请求的草稿长度设到最大。
DSpark 在 backbone 预训练后单独引入;随后随 backbone 的后训练继续适配,但 DSpark loss 不反向影响 backbone。更详细的接受、验证和状态回滚见第 17 章。
本章组件和数值来自报告 §2.1、§2.4、§3.1.3、§4.2.1;不应将图中 Engram 或 DSpark 理解为另一份普通 Global KV。技术报告
3. 四十层的准确布局与数据依赖
3.1 从图中的重复次数推导层数
Encoder:
前两层 SWA-only;之后三个组,每组一个 Full 和五个 Reuse。
Decoder:
首组一个 Full 和三个 Reuse;后面四组各一个 Reindex 和三个 Reuse。
3.2 完整层映射
| 层号 | 模块 | Attention 类型 | Global KV 来源 | 当前 query 的 Top-K 来源 |
|---|---|---|---|---|
| L0–L1 | Encoder | SWA-only | 无 | 无 |
| L2 | Encoder | Full, | L2 新建 | L2 新算 |
| L3–L7 | Encoder | Reuse | L2 | L2 |
| L8 | Encoder | Full, | L8 新建 | L8 新算 |
| L9–L13 | Encoder | Reuse | L8 | L8 |
| L14 | Encoder | Full, | L14 新建 | L14 新算 |
| L15–L19 | Encoder | Reuse | L14 | L14 |
| L20 | Decoder | Full, | 从 Encoder final hidden 新建 | L20 新算,同时建 Candidate Pool |
| L21–L23 | Decoder | Reuse | L20 | L20 |
| L24 | Decoder | Reindex | L20 | L24 新算 |
| L25–L27 | Decoder | Reuse | L20 | L24 |
| L28 | Decoder | Reindex | L20 | L28 新算 |
| L29–L31 | Decoder | Reuse | L20 | L28 |
| L32 | Decoder | Reindex | L20 | L32 新算 |
| L33–L35 | Decoder | Reuse | L20 | L32 |
| L36 | Decoder | Reindex | L20 | L36 新算 |
| L37–L39 | Decoder | Reuse | L20 | L36 |
合计四个 KV source、八个 index source、三十个 Reuse CSA2 层、两个 SWA-only 层。四十个 backbone 层都有自己的局部 SWA。
图 2 的关键是把“记忆内容来自哪一层”和“选择哪些记忆来自哪一层”分开。 图中的“本层投影 Global KV”在 L20 的输入恰好就是 Encoder final hidden;不能推广成每个 Decoder 层都生成一份 Global KV。“本层 Q + L20 K”在路由框中指 Indexer Q/K,不是把 Main Q 和 Indexer K 直接相乘。
3.3 层间共享并不取消层间计算依赖
对于相邻层:
后一层的 query 需要前一层的新输出。因此,虽然 L25、L26 可以访问同一个 Global KV 和同一份 Top-K,它们的 query、attention weights、SWA KV、输出投影、MoE 都不同。
跨层 KV 共享减少的是重复存储和部分计算,不是把 20 层网络变成 20 个无依赖的并行读者。训练中的 pipeline parallel 或不同请求之间的并行,是另外一层调度问题。
4. CSA2 在整个模型中的职责
4.1 三个互相独立的压缩维度
将传统逐层缓存抽象为:
CSA2 同时控制:
- entry width:共享 512 维 Main KV latent,配合低精度;
- position:Encoder 每两个位置合成一个 entry,Decoder 保留逐 token entry;
- layer:只在四个 source 层生成全局缓存,其余层复用。
DSA 式的 Top-K 还控制每次真正参与昂贵 core attention 的条目数。存多少、选多少、读多少次,是不同问题。
4.2 Full、Reindex、Reuse 的组件图
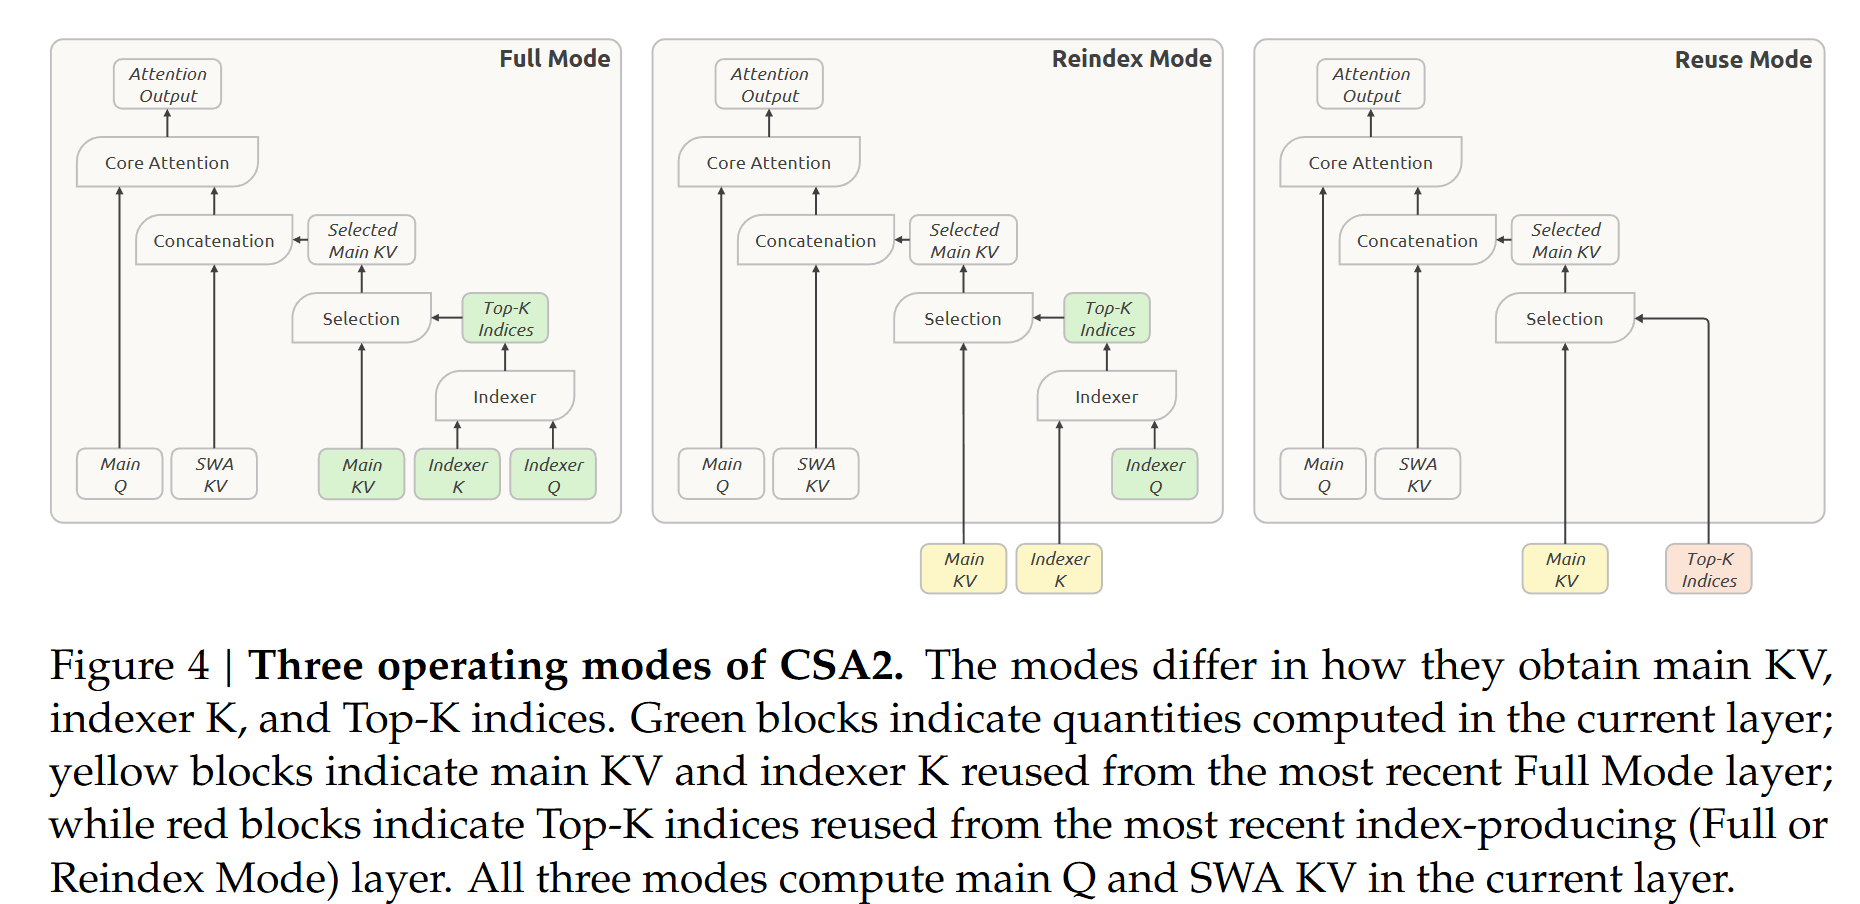
从下往上读三列:
| 行为 | Full | Reindex | Reuse |
|---|---|---|---|
| Main Q | 本层生成 | 本层生成 | 本层生成 |
| SWA KV | 本层生成 | 本层生成 | 本层生成 |
| Global Main KV | source 生成/追加 | 复用既有 source | 复用既有 source |
| Indexer K | source 生成/追加 | 复用既有 source | 不重新生成 |
| Indexer Q | 本层生成 | 本层生成 | 不生成 |
| Top-K | 本层索引产生 | 本层重新索引 | 复用最近 index source 的选择 |
| Core Attention / MoE | 本层执行 | 本层执行 | 本层执行 |
Full 负责建立“记忆库”,Reindex 负责重新“检索”,Reuse 负责沿用“检索结果”。所有层都要用自己的 Main Q 真正读取选中的内容。
在批量 Prefill 中,每个 query 位置都有自己的 Top-K;在 Decode 中,每个新 token 也会产生新的 Top-K。跨层复用不代表跨所有时间步永久固定一份位置清单。
4.3 Main KV 和 Indexer K 不要混淆
Main KV 是主 attention 读取的内容,dimension 为 512;Indexer K 是轻量检索用的键,dimension 为 128。两者有不同的计算用途和量化尺度布局。
CSA2 先生成 normalized、尚未施加 Main RoPE 的主 latent,再投影出 Indexer K。之后两条路径分别应用相应的位置处理和量化。简写成:
这是执行关系示意,省略了具体 normalization 参数和实现细节。不能把它理解为“从已经存成 FP4 的 Main KV 解码出来,再在线反复生成所有 Indexer K”。
4.4 Hierarchical Sparse Indexer
图 3A:Decoder 的 Global KV、Top-K 和 Candidate Pool 跨层共享
下面是此前讲解中遗漏的完整 Decoder 共享关系图,与你指出的截图对应。它把三种不同的共享对象画在一起:Global memory、当前 query 的 Candidate Pool、各 index source 产生的 Top-K。
这张图要沿三类路径分别阅读:
- 记忆内容路径。 Encoder final hidden 经 L20 的投影形成唯一的 Decoder Main KV 和对应 Indexer K。L20–L39 的 Global 分支都以这一份 memory 为来源;不是 L24、L28 等层又创建了新的完整 Global pool。
- 首组选择路径。 L20 的 Full indexer 使用自己的 Indexer Q 对因果可见的 Indexer K 评分,得到 Top-K 20;L21–L23 复用这份位置选择。图中的数字 20 是来源层号,不表示只选 20 项。
- 候选池路径。 同一次 L20 索引还为当前 query 生成 Candidate Pool,交给后续 Reindex 层作为搜索范围。它不是所有 token 永久共用的一份池,也不是另存一份 Main KV。
- L24 组的路径。 L24 读取共享 Indexer K,并用自己的 Indexer Q 在候选池内重评分,生成 Top-K 24。L25–L27 沿用这个新选择,但读取的 Main KV 仍来自 L20。
- 后续三组。 L28、L32、L36 分别重评分;各自后面的三层分别复用对应选择。它们共享候选范围,不要求最终 Top-K 完全相同。
- 图中省略但仍要执行的路径。 所有层都重新计算自己的 Main Q、SWA KV、attention output、输出投影和 MoE。因此虚线“同一份 Global KV”表示内容共享,不是输出共享,更不意味着模型层可以无依赖并行。
例如 L25 的 Global 来源是 L20、Top-K 来源是 L24、局部 SWA 来源是 L25。这三个 source 不一致,正是应将“内容所有权”和“路由所有权”分开管理的原因。
L20 对全部因果可见位置做初次索引,得到自己的 Top-512,同时把相邻八个位置组成一个候选 block:
选最多 2048 个 block,形成候选池:
L24、L28、L32、L36 分别用自己的 Indexer Q,在当前 query 的候选池内重新选 Top-512。
候选池只规定“后续 indexer 可以到哪里找”;Top-K 才规定“这一层 core attention 真正读取哪些 entry”。它们是 query-local routing state,不是第五份长期 KV Pool。
第一层如果完全漏掉一个区域,后面的 Reindex 无法跳出候选池恢复它。该机制在后训练中进行适配。即使后四次索引的工作量有界,最初的全局扫描仍存在,不能把整个 Decode 严格写成 。
4.5 Decoder 不压缩 token,收益为什么仍然很大
Decoder 的确是:
但同时发生了五件事:
- 二十层只保留一份 Global KV,而不是二十份。
- 每个 Main entry 是跨 heads 共享的 512 维 latent,并使用 FP4。
- 主 attention 通常只处理最多 Top-512 加 SWA-128,而不是全部 个位置。
- 二十层中只有五层进行索引,后四层只在候选池搜索。
- Prefill 的绝大多数历史 query 不再穿过 Decoder 主体。
保留 Decoder 的逐 token 分辨率、再通过 layer sharing 控制缓存,是合理的结构解释;“为什么不是 ”没有一个可从图直接证明的唯一因果答案,应视为精度、缓存和计算的设计折中,而不是声称作者已经证明 最优。
5. Global KV 与 SWA KV:不是同一份数据的两个名字
5.1 “Global”首先描述时间覆盖范围
Global 表示它可以覆盖长历史,而不是“Global 这个词天然就表示跨层”。传统全注意力的 KV 也覆盖全局历史,但通常每层单独保存。
在 CSA2 中恰好有两个属性叠加:
- 时间上覆盖长上下文;
- 深度上由多个层共享同一个 source。
SWA 则有另外两个属性:时间上只保留近期窗口,深度上每层独立生成。
5.2 SWA 的原理
设窗口长度为 ,当前位置采用从一开始的编号。其允许访问的局部位置为:
| 当前位置 | 可见的局部窗口 |
|---|---|
| 到 | |
| 到 | |
| 到 | |
| 到 | |
| 到 |
单独看 SWA 分支,注意力是普通 attention 加局部 mask:
这不表示 CSA2 必须独立计算一次 SWA softmax;实际 CSA2 把局部 entry 和选中的 Global entry 放到同一个 core attention,后面解释其联合归一化。
Decode 中可使用 ring buffer:新 token 的局部 KV 写入下一个槽位,超过窗口后覆盖最老位置。槽位索引和绝对位置必须分开,不能让 ring wraparound 破坏 RoPE 和因果顺序。
5.3 为什么不是只有前两层有 SWA
图中前两层明确画成 SWA,是因为它们是 SWA-only,没有 Global 分支。后面的 CSA2 方框内部仍包含 SWA KV,第二张组件图对此画得很清楚。
所以实际是:
每层的 hidden representation 不同,局部 KV 对应不同深度的表示。保留这条路径,能保留局部计算的层间深度,而不是让所有局部交互也降为对同一座浅层记忆库反复读取。
SWA 的作用还包括:保留近期细节;补偿压缩和稀疏选择的遗漏;在 Encoder 压缩 block 尚未完成时保证近期 token 可被因果访问。SWA 窗口外的远程信息仍可通过 Global 路径参与注意力。
5.4 最后 128 个 token 是否同时出现在两条路径
可能出现。这里要区分:
- 位置覆盖重叠:同一个原始 token 的信息可能出现在 Global 和 SWA;
- 数值相同:两份 KV 张量是否完全一样。
前者可能成立,后者一般不成立。
Decoder 的 Global latent 来自:
第 层的 SWA latent 来自:
当 时,输入 hidden 的深度已不同,投影参数也不同。即使 L20 的两条路径都从 Encoder 输出开始,Global projection 和 SWA projection 也不是同一条投影路径。
此外 Encoder Global 还做了二合一的序列压缩,而局部 SWA 保留独立 token;Global 使用 FP4,SWA 保留 FP8。覆盖相同位置,不等于可以复用同一份字节。
图示没有规定 Global Top-K 必须排除最近窗口。不能自行添加“Global 只看 128 以外”的规则来解释两者。它们在语义上承担长程检索和近期精细建模的互补角色,但其位置集合不必严格互斥。
5.5 “Concatenation”到底沿哪个维度拼接
对一个 query、一层 attention,假设选中 个 Global entries,局部有 个有效 entries:
逻辑拼接为:
如果 、,则为:
是沿 entry / 被关注位置轴拼接,不是把每个 token 的特征从 512 维拼成 1024 维。
对 Main Query head :
这里利用 shared Key–Value latent,即 ,并省略了 sink 和无效位置 mask。若含 learned attention sink,其分数还会进入归一化分母,具体按 kernel 语义处理。
Global 和 SWA 的 logits 在同一个 softmax 下竞争权重。这与“Global 单独 softmax、SWA 单独 softmax,然后直接相加”通常不等价。
如果两个 entry 都与原始位置 有关,它们仍是两个不同表示、两项不同 logits,而不是必须做去重的同一个元素。
5.6 逻辑拼接不要求物理复制
实际 kernel 可以直接收到:Global block table、Top-K indices、局部 ring buffer、有效长度和 mask,然后分别 gather 两个来源,在同一个 online softmax 中处理。
所以不一定需要每一层先复制出一个新的 数组。在线 softmax 可融合不同 tile 的最大值、归一化和加权和,只要保留统一归一化语义即可。
5.7 为什么不能直接取 Global 最近 128 项代替 SWA
原因不是“框架暂时没有实现”这么简单,而是张量语义不同:
- Global 是 source 层或 Encoder final hidden 的投影;SWA 是当前层 hidden 的投影。
- Encoder Global 一个 entry 混合两个位置,不存在一一对应的最近 128 项未压缩局部 KV。
- 不同路径的参数、位置处理和精度不同。
- 深层局部 KV 包含经历中间层计算后的信息,无法仅从 source KV 无损反推。
可以研究让模型重新设计、重新训练后共享局部 KV;但那是模型结构变更,不是对现有 V4.1 checkpoint 做零损失缓存去重。
5.8 “所有层都能读取”不等于“所有层都存一份”
例如:
是同一个逻辑 Global source; 和 是不同局部状态。两层还会产生不同的 query 和输出。
一个 GPU allocator 可以把四个 Global sources 放在同一个物理 pool 中,也可以分别建 pool;那是存储实现选择。“四份 source”描述模型所有权,不强制要求恰好四个独立的显存分配器。
6. Compressor、压缩尾部与符号解释
6.1 ratio=2 的正常结果
当输入长度为 ,每个 Encoder source 完成的条目数为:
因此“1024 个 prompt token 产生 512 个 entry”是正确的,但这是每一个 Encoder source 的数量。Encoder 有三个 source,合计为三份各 512 项的 memory;Decoder 还有一份 1024 项的 memory。
| 已处理位置数 | 每个 Encoder source 的完整 entry | 未完成组中的 token 数 |
|---|---|---|
6.2 压缩尾部状态不是额外的 512 项缓存
将两项压成一项时,先生成 projected values 和 gates:
对组内两个 token、某个 channel :
只到达第一项时,还不知道第二项的 projected value 和 gate,不能宣称最终 compressed entry 已完成。需暂存第一项的状态,等下一项到来再生成完整条目。
实现可保存 ,也可保存等价的在线归一化累计量;这些都属于 compressor tail state。它不等于“最近 128 个 SWA KV”,也不等于“已经完成压缩的全局条目”。三个 Encoder source 分别维护自己的尾部,因为投影来自不同层。
压缩组尚未完成时,不可让更早 query 读取包含未来 token 信息的完整组。可见性必须按原始 token 的因果位置判断;SWA 为未完成尾部提供直接的局部访问路径。
6.3 Compressor 简化的含义
V4 CSA 对一个输出使用当前组的一条投影流和前一组的另一条投影流:窗口覆盖 个位置,步长为 ,相邻输出重叠;Main 与 Indexer K 还有独立压缩路径。
CSA2 改为单流、非重叠 pooling:
这里 仅示意每个位置的投影特征,不是直接把两个 token ID 平均。它仍使用逐 channel 的 learned weights;删除的是 compressor 内的绝对位置 bias 和重叠路径,不是删掉所有 RoPE。
这样减少了投影、边界处理和尾部状态的复杂度。V4 CSA/HCA 的完整对照、双流公式和伪代码全部保留在附录 A。
6.4 Decoder ratio=1 时为什么没有这种尾部
单个 token 就是一组,组内 softmax 恒为一:
因此 gate pooling 退化为直接投影和 normalization:
没有“等下一项凑满压缩组”的需求。但 Decoder 仍然有 SWA ring state、Global KV、Indexer K;不能因为没有 compression tail 就说 Decoder 无状态。
6.5 的每个符号
| 符号 | 含义 |
|---|---|
| Causal Encoder 的 final hidden states,覆盖对应输入位置 | |
| 主注意力使用的共享 Key–Value latent / Main KV 集合 | |
| 上标 | Decoder 来源或用途标记,不是维度,不是求幂 |
| Indexer,即轻量检索路径 | |
| Decoder Global memory 对应的 Indexer Keys |
更明确的示意关系是:
随后分别进行位置处理和量化,写入相应缓存。 通常按一个 512 维 latent 同时承担 key 和 value,而不是必须存两份完整的 数组。
6.6 Encoder 和 Decoder 是否各自有 Global Pool
逻辑上是:
各 又包含 Main KV 和 Indexer K。Encoder 的三个来源与 Decoder 的一个来源不相同;Decoder 不是把 Encoder 三份 pool 直接改名后共享。它从更深的 Encoder final hidden 新投影出自己的 memory。
至于这些逻辑对象是否由一个统一的 Global KV allocator 管理,是系统实现问题。
7. 冷启动 Prefill 的完整执行流水线
本章先假设没有命中任何可复用 prefix,prompt 长度为 ,且正常执行而非推测分支。Prefix 命中的变化放在第 11、12 章。
7.1 阶段 A:准备输入与预取
图 5:冷 Prefill 的完整状态生成与尾窗计算
这张图把全部 prompt 的 Encoder 计算、四个 Global sources 的形成和 Decoder 尾窗计算分开。下面各阶段按此图展开。
逐条读图:
- 全部 个输入位置通过 20 层 Causal Encoder。这是无 prefix 命中的冷 Prefill;命中情况下使用第 11、12 章的复用与恢复流程。
- Encoder 向三个方向产生结果:三份 Global memory、每层 SWA 与压缩尾部,以及 final hidden。三者生命周期不同,不能统称为一块 KV。
- 所有位置的 Encoder final hidden 都为 Decoder Global 提供投影输入,因此 Decoder memory 覆盖全 prompt。
- 同一批 final hidden 的尾部 个位置作为 query 输入,依次经过全部 20 层 Decoder;前面的 query 位置不执行这条完整路径。
- Decoder replay 一方面读完整的因果可见 Global memory,另一方面在截断的局部窗口内建立各层 SWA。
- 最后位置的 logits 用于采样首个输出 token;该 sampled token 要在后续输入模型时才会生成自己的完整主模型状态。
图中的“保留末尾”只限制 Decoder query 执行范围,不把 Global history 截断到 128 项。
入口进行 tokenization、图像解码和必要预处理,生成统一位置序列。视觉输入先经过 Vision Encoder 和 projector。文本 embedding 与 visual embeddings 在对应位置合并。
同时,Engram 可以根据 token IDs 提前计算哈希地址并发起预取。它不必等待所有中间 hidden 产生后,才知道要读哪些表项。
实际执行应把独立工作重叠,例如视觉编码、缓存查询、Engram 预取;下面按依赖顺序叙述,不表示它们必须严格串行。
7.2 阶段 B:全部位置通过 Causal Encoder
对 个位置运行 L0–L19,得到:
- 三个 Encoder Global sources:;
- 每个 Encoder 层的局部 SWA 状态;
- 三个 ratio-2 source 的未完成压缩尾部;
- 对应位置的 Encoder final hidden 。
第 层处理不同位置可以采用 causal prefill kernel 并行,不是在 Prefill 中逐 token 串行循环 次。但层与层仍然有 hidden-state 依赖;长 prompt 也可以被切成 chunks,保持各 chunk 的因果状态后继续。
这里“每层最后 128 项”描述 Prefill 完成后为继续执行保留的局部运行状态。在 Prefill 的计算期间,某些实现会临时生成一个 chunk 或更大范围的局部 KV 张量,不能由最终 ring 容量推断所有临时 buffer 都只有 128 项。
7.3 阶段 C:从全部 Encoder outputs 建立 Decoder Global KV
需要的是:
Decoder ratio 为一,所以全部 prompt 位置都产生相应的全局条目。这个过程包括 Main latent 投影、Indexer K 投影、位置处理、量化和缓存写入,但不需要这些位置各自跑完整 20 层 Decoder。
因此必须区分两件事:
- 给一个位置生成未来能被检索的 Global KV;
- 把该位置作为 query,运行 Decoder Attention + MoE 的整条深层计算。
CED 让大多数历史位置只做前者。
工程上可在 Encoder chunk 输出就绪时立即投影 Global KV,避免永久保留整个 的 ;但尾部 replay 所需的 Encoder outputs 要保留或以其他方式供应。具体 activation buffer 和同步策略不由架构图唯一决定。
7.4 阶段 D:只让尾部 query 通过全部 Decoder
设:
取最后 个 Encoder outputs:
依次通过 L20–L39。在此过程中:
- Global memory 可以覆盖全部因果可见 prompt;
- 每个尾部 query 仍需要遵守自己的 causal mask;
- 每层生成该尾段自己的 SWA KV;
- 局部 SWA 访问范围截断在 replay segment 内;
- Full/Reindex 为各 query 产生选择,Reuse 在层间复用;
- 最后位置产生输出 logits。
这一过程建立 Decoder 的运行时 SWA,供后续 Decode 使用。不能把它叫“只执行 Decoder 一层”,它是“较少位置执行所有 Decoder 层”。
7.5 为何不是只保留 128 个历史 token
只裁剪的是继续穿过 Decoder 的 query hidden 序列,不是把全部 Global memory 裁成 128 项。
在 的例子中,Prefill 完成时有:
| 状态 | 逻辑规模 |
|---|---|
| Encoder Global | 三份,每份 512 个完整 entry |
| Decoder Global | 一份,1024 个 entry |
| Encoder SWA | 20 层,每层最多 128 个 entry |
| Decoder SWA | 20 层,每层最多 128 个 entry |
| Encoder compression tail | 此时三个 source 都没有未配对项 |
| Indexer K | 对应四个 Global source 的各条目 |
| Top-K / candidates | 当前 query 的临时路由信息 |
所以“Encoder 后只保留 128”如果没有对象限定,会让人误以为 896 个历史 token 全部丢掉。准确说法是:全序列进入 Decoder Global memory,尾部最多 128 个位置继续执行 Decoder 主体。
7.6 128 是静态值还是动态值
是此模型配置的 SWA window size,也是报告 bounded replay 使用的上限。短 prompt 只能重放已有位置,因此实际长度为 。
它不是每次根据 Top-K 动态挑出的 128 个位置,也不是可以只改服务端参数而保证模型语义和质量不变的任意旋钮。若研究动态 replay 长度,需要重新评估精度、边界行为和训练适配。
7.7 粗粒度计算量怎样理解
仅按“处理多少 token-layer”估算:
完整 40 层 Prefill 的对照为 。长 prompt 下,主体深层计算接近减半。
这不是精确 FLOPs 公式,也不是声称总 Prefill 对 严格线性。它省略了 Global projection、context-dependent indexing、量化、MoE 通信、视觉编码以及 kernel 效率。报告用这个形式表达计算深度节省,不能把它直接当成端到端延迟预测器。
8. Decode 的逐 token 执行与状态更新
8.1 先分清采样时刻与写缓存时刻
Prompt 最后位置的 logits 用于采样第一个输出 token 。此时主模型 cache 通常覆盖的是 prompt,不是已经把 的整层 KV 都写完。
下一轮将 输入模型,更新它对应的所有状态,输出用于预测 的 logits:
在 P→D 交接和最后一个 sampled token 的缓存持久化中,这个“已采样但未消费”的差别尤其重要。
8.2 新输入 token 通过 Encoder
一个新位置依次执行 L0–L19:
- 每层计算 Main Q 和自己的 SWA KV。
- 更新该层 ring buffer,淘汰窗口外的位置。
- 在 L2、L8、L14 更新各自 compressor tail。
- 如果凑满二项组,生成新 compressed Main KV 和 Indexer K。
- Encoder Full 层索引当前可见 compressed memory,Reuse 沿用相应选择。
- 每层继续执行 output projection、residual/mHC、MoE 等计算。
即使这一步还没有形成新 Global entry,新 token 的近期信息也可经 SWA 参与本层计算。
8.3 新输入 token 通过 Decoder
得到新 后:
- L20 的 Global path 追加一项 Main KV 和 Indexer K。
- L20 全局索引,生成当前 query 的 Top-K 和候选池。
- L21–L23 复用该选择,但计算自己的 query 和局部状态。
- L24、L28、L32、L36 在同一 query 的候选池中分别重新索引。
- 其间的 Reuse 层沿用最近一次选择。
- 全部 20 个 Decoder 层更新自己的 SWA,并执行自己的 MoE。
- 最终输出新的 logits。
普通 Decode 每个输入 token 经过 40 层。CED 不是一个让生成阶段只执行半个模型的早退机制。
8.4 从 1024 到 1026 的状态演化
若 prompt 恰好长 1024:
- 刚采样 :cache 仍覆盖 1024 个已处理位置。
- 消费 ,已处理长度变为 1025:每个 Encoder source 仍有 512 个完整 entry,另有一个待配对状态;Decoder Global 增至 1025 项。
- 消费 ,已处理长度变为 1026:每个 Encoder source 增至 513 项,tail 清空;Decoder Global 增至 1026 项。
四十个 SWA ring 每次都滑动,Top-K 和 Candidate Pool 则按新 query 更新。候选池不是积累成越来越长的第五条缓存。
9. CED 与 YOCO:到底跳过了什么
9.1 共同思想:上半模型的长期记忆不依赖所有上半层历史输出
传统逐层 self-attention 需要每个历史位置经过每一层,才能获得那一层未来要读取的 KV。
当上半模型的 Global KV 已由下半模型提供时,早期历史位置不必继续通过所有上半层来制造另一套逐层 Global KV。这就是能够省去上半部分大规模 Prefill 的依赖依据。
但“上半层都读同一份 memory”不代表它们的 query 和输出不再层层依赖。
9.2 YOCO 不是“上半模型只跑一层”
纯共享 cross-decoder 的直观情况是:历史 memory 就绪后,为产生下一个 token,只需要保留最后一个 query 位置,但这个位置仍经过全部上半层。
应该说:
而不是:
9.3 V4.1 为什么还要处理最后 128 个位置
V4.1 的上半模型保留逐层 SWA。未来 token 需要的不只是共享 Global memory,还有各层最近历史的局部 KV。
因此,不能像没有这类局部历史依赖的纯 cross-attention 上半模型那样,仅用最后一个 query 就精确重建所有状态。V4.1 使用 bounded replay,让尾窗经过全部 Decoder 层来近似恢复这些局部状态。
| 维度 | YOCO 共享 cross-decoder 的核心思路 | V4.1 CED + CSA2 |
|---|---|---|
| 上层长期 KV 来源 | 下半模型 | Encoder final hidden 投影出的 Global memory |
| 历史上层 query 是否都必算 | 不必 | 不必 |
| 后续层 hidden 是否串行依赖 | 是 | 是 |
| 上层逐层局部 SWA 历史 | 不是纯 cross-decoder 省算论证的依赖 | 明确保留 |
| Prefill 上层保留的位置 | 通常关注最后 query | 最后最多 128 个 query |
| 跳过历史的精确性 | 来自对应结构的精确依赖消除 | Global 路径可省算;局部状态采用近似恢复 |
这是结构关系的比较,不是在宣称两个模型的参数、注意力算子和具体 cache layout 完全相同。YOCO 论文
10. KV Cache 的对象、所有权和生命周期
10.1 必须先给“缓存”分类
“KV 被 cache 了吗?”至少有三种含义:
- 当前请求生成时,是否在 GPU 内保留,避免下一步重算?
- 请求完成后,是否保留供下次 prefix 命中?
- 是否进一步持久化到 SSD、保留较长时间?
Decoder SWA 在第一种意义上当然被缓存,但报告明确说它不用于第二种 prefix caching。不能把“不持久化”解释成“每一步都没有局部缓存”。
10.2 全部关键状态表
| 对象 | 生产者 / owner | 活跃期用途 | Prefix 复用与结束后的处理 |
|---|---|---|---|
| Encoder Main KV | L2、L8、L14 | 长程主 attention 读取 | 可长期保留并按 prefix 复用 |
| Encoder Indexer K | 同上 | 轻量检索 | 随相应 Global memory 保留 |
| Decoder Main KV | L20,从 投影 | 20 层共享的长程读取 | 同样可以长期保留,不仅 Encoder 才持久化 |
| Decoder Indexer K | L20 | 全局初筛和候选重打分 | 随 Decoder Global memory 保留 |
| Encoder SWA | L0–L19 各层 | 后续 query 的局部历史 | 可进入短 TTL host-DRAM 池;缺失时 replay |
| Decoder SWA | L20–L39 各层 | 当前生成序列的局部历史 | 不进入 prefix cache;无消费者后释放 |
| Encoder compressor tail | L2、L8、L14 | 完成下一压缩组 | 必须保存、传输或按协议恢复,不能当完整 entry |
| Top-K indices | Full/Reindex | 当前 query 的稀疏选择 | 临时,不是跨请求固定缓存 |
| Candidate Pool | L20 | 当前 query 后续 Reindex 的搜索域 | 临时,完成消费者后释放 |
| Encoder final hidden | Encoder 输出 | 生成 Decoder Global 和尾窗输入 | 通常为 activation;保留范围取决于 replay 协议 |
| mHC residual streams | 当前 forward | 跨层 residual 计算 | 临时 activation,不是历史 attention cache |
| DSpark tentative state | drafter / verifier | 推测草稿和验证 | 仅接受部分提交,拒绝部分回滚或丢弃 |
Engram table 是模型权重,生命周期与请求 cache 不同;不能计入这张表的 Global KV 容量。
10.3 Global KV 的生命周期
正常生命周期可理解为:
报告区分 runtime Global KV 和 persistent KV:活跃生成需要的完整全局缓存保留在 HBM;持久副本位于 SSD 或 host memory,以便后续请求重用。这不意味着 Global 每一步都从 SSD 读取。
报告描述其部署的 Global cache 保留至少 72 小时。这是特定系统的存储政策,不是模型数学结构强制的 TTL,也不能推导成所有第三方实现都有相同保障。
10.4 Encoder SWA 为什么用短 TTL 池
SWA snapshot 与某个具体序列边界绑定。它通常对短时间内续写、继续对话有价值,而不像 Global prefix 那样存在长尾复用。
报告将约每台机器 10% 的 host DRAM 组成分布式短 TTL 池,分钟级回收。这里结合下一节的明确说明,应理解为可复用的 Encoder SWA;Decoder SWA 不用于 prefix caching。
十轮短对话如果为多个边界都保存完整逐层 SWA snapshot,即使每个 snapshot 只有一个小窗口,总量也会很可观。容量有界的单请求运行状态,并不意味着跨会话持久化成本可以忽略。
10.5 Decoder SWA 不缓存,是请求结束立即无条件清空吗
准确说法是:它不进入跨请求的 prefix cache,但在当前 Decode 持续使用;如果需要迁移当前活跃生成任务,它也是正确续跑所需的运行状态之一。
当请求完成、取消,且没有活跃分支或消费者继续依赖它时,才可以释放。释放时机可受异步 kernel、传输、引用计数影响,并不等于采样器一产生 EOS 就可以立即覆盖所有内存。
10.6 容量推导:为何是 890 bytes/token
Main KV 为 512 个 FP4 值,每 16 值一个一字节 scale:
Indexer K 为 128 个 FP4 值,每 32 值一个一字节 scale:
所以每个 source entry:
对已处理长度 :
这里不包含 SWA、compression tail、页表、对齐、allocator 碎片、临时工作区、模型权重、activation 和传输协议开销。
若只粗算 FP8 SWA payload:
这约为 2.5 MiB/请求,不含 scale 和 metadata;它是固定局部状态,而 Global 随 增长。短上下文、小 suffix、多活跃请求场景下,这项固定成本仍值得重视。
10.7 FP4 缓存的数值格式与位置处理
压缩和量化是两件事:ratio-2 learned pooling 改变 sequence entry 数量;FP4 改变每个数值的存储格式。Decoder ratio 为一,仍可从 FP4 获得显著缓存收益。
V4.1 Main KV 使用 E2M1 四位 payload,每 16 个 channel 一个 E4M3 scale。它沿用类似 NVFP4 的分组思路,但省去第二级 global scale。Indexer 则采用面向广泛硬件支持的 MXFP4 路径,其 scale 分组与 Main KV 不同。
为什么 Main KV 可以去掉第二级 scale?报告用数值范围说明:该格式可表示的幅值范围足够大,约为:
而 512 维 latent 经 RMSNorm 后,在 normalization weights 幅值约不超过一的条件下,向量范数约受:
限制。RoPE 是旋转,保留向量范数,单个 channel 的绝对值也不超过该范数上界。报告观察到训练中的最大幅值约为 10,远小于上述格式范围。这里的界依赖已训练 normalization 参数的实际范围,不是任意 RMSNorm 权重都自动满足的普适定理。
Main KV 在 RoPE 之后量化,非 RoPE 部分和 RoPE 部分使用同一种四位格式。这样 Decode 读取缓存后不必对每个历史条目重新施加 RoPE。报告把 Main KV FP4 主要定位为存储压缩:attention 前可反量化,不要求主 attention 直接依赖该格式的原生 FP4 矩阵乘。
SWA 对量化更敏感,仍保留 FP8。因此“Global 的最近 128 项可以直接兼作 SWA”也不能只根据位置数和维度一致来判断。
训练中通过 QAT 让模型适应低精度缓存,Main KV 的 FP4 QAT 在后训练引入。不能把对训练已适配模型的结果,推广成任意现成模型直接把 KV 改成四位都几乎不掉点。报告 §2.4.4
11. Prefix Caching 与近似状态恢复
11.1 命中 Global 不等于全部状态都齐全
对于已命中的 prefix,至少要分别问:
- 四个 Global source 的完整条目是否都可用?
- Encoder 的逐层 SWA snapshot 是否可用、对应哪个边界?
- ratio-2 的边界是否对齐,未完成组的状态怎样恢复?
- Decoder 尾窗需要的 Encoder final hidden 从哪里获得?
不能只查一个“prefix length”整数,就默认所有类型状态都完整。
11.2 Global + Encoder SWA 都命中
若缓存契约还供应了正确的 compressor boundary state,可以从命中边界继续处理 uncached suffix,避免 Encoder SWA 缺失时的恢复。
但 Decoder SWA 仍按报告策略在每次 Prefill 通过尾窗重建。若 suffix 长度小于 128,Decoder 尾窗会包含已缓存 prefix 的若干位置;需要给出那些位置对应的 Encoder outputs。
一个重要的实现边界:Global KV 不能无损反推任意 。 系统需要额外保留必要的尾部 activation、安排适当重计算,或者有等价的数据供应协议。报告描述了 bounded replay 原理,但没有公开完整生产 cache-hit activation 供应协议;本文不编造具体实现。
11.3 Global 命中、Encoder SWA 缺失
设命中 prefix 结束边界为 ,完整 prompt 结束边界为 :
Encoder replay 区间为:
这段 token 重新通过 Encoder,用已有 Global memory 辅助重建各层 SWA,然后继续处理 suffix。
- replayed prefix 复用原 Global KV,不覆盖、不重复追加;
- suffix 产生新的 Global KV、SWA 和必要的尾部状态;
- query 的 Global 可见性仍要按因果位置遮罩,即使 cache 中存在该 query 之后的已缓存条目,也不能提前读取未来。
已有 Global KV 只读重用不意味着恢复出来的局部 hidden 和原完整执行数学上完全一致。
11.4 为什么只 replay 128 是近似恢复
单层 SWA 看最近 个位置,但这些位置的 hidden 来自上一层,上一层又看它们更早的窗口。局部依赖随层数展开。
因此要精确重建多层末端状态,所需历史 token 范围会随层数增长,报告用约 个历史位置描述其规模。
这里 是历史 token 范围,不是“总共只做 个 token-layer 运算”。 这些位置还要经过相应层,不能混淆输入跨度和计算工作量。
Bounded replay 只取最近 个位置。设 replay 从 开始,当前位置 的局部访问为:
较早于 的局部依赖被截断。即使最后一个 query 表面上已经拥有满 128 项窗口,窗口内深层 KV 也可能继承了前面截断的误差,不能据此宣称它自动恢复成精确状态。
Global 路径仍可覆盖完整因果历史,这是近似恢复能够利用的信息来源,但它不能证明与原始逐层 SWA 完全等价。
11.5 Decoder replay 与 Encoder replay 目的不同
| 对比项 | Encoder replay | Decoder replay |
|---|---|---|
| 主要触发原因 | 已命中 Global,但 Encoder SWA 缺失 | 每次 Prefill 都不使用旧 Decoder SWA prefix cache |
| 边界 | cache-hit 结束位置 | 完整 prompt 结束位置 |
| 输入区间 | prefix 的最后 个位置 | 完整 prompt 的最后 个位置 |
| 目标 | 恢复从 继续的 Encoder 局部状态 | 建立接下来生成所需的 Decoder 局部状态 |
| Global | 缓存前缀只读复用;suffix 新增 | 读取覆盖 prompt 的 Decoder Global memory |
| 是否精确 | 一般不是 | 一般不是 |
报告观察到质量影响较小,并在后训练中模拟 Decoder replay 以适配部署行为。这个结论是实验观察,不是对任意输入、任意命中点的数学精确性保证。报告 §3.2.1–§3.2.2
12. 两种 Replay、两个边界:完整数值例子
图中使用从零开始的半开区间,参数为:
图底部提及的“后文 128-token suffix 真实实验配置与数据”是所附讲解图的原有说明;本文仅使用此图解释机制,不据此补造实验数据,也不把本节的 suffix 四项例子当作官方 benchmark。
12.1 第一行:Global prefix 的边界
已经命中:
只有:
这四个新位置需要追加 Global memory。已命中部分只读复用,不因 replay 而覆盖,也不重复计入新长度。
12.2 第二行:Encoder 的恢复边界是
如果 Encoder SWA 未命中,需要先重放:
共 128 个 prefix 位置,再处理四个 suffix 位置:
这个例子中,Encoder 需要处理的位置数为:
“只新增四个 token”并不意味着只执行四个 Encoder token,因为还存在缺失局部状态的恢复成本。
12.3 第三行:Decoder 的尾窗边界是
Decoder replay 为:
它由两部分构成:
对应:
因此,即使 uncached suffix 只有四个 token,Decoder 也并非只处理四个 query。它需要完整 prompt 的最后 128 个 Encoder outputs。
12.4 两个起点为什么相差四
Encoder 的目的,是恢复“从 cache-hit 边界继续算”的状态;Decoder 的目的,是建立“从完整 prompt 末端开始生成”的状态。两者边界不同,完全正常。
在这个 Encoder SWA miss 的例子中,Encoder replay 和 suffix forward 产生了从 3968 到 4100 的 outputs,因此覆盖了 Decoder 需要的 3972 到 4100。
若 Encoder SWA 命中而完全不重放 prefix,不能省略第 11.2 节提到的尾部 供应问题。图中 miss 路径的数据齐全,并不自动解决所有 hit 路径。
12.5 此时 Global memory 增长多少
由于 是偶数,ratio-2 组在命中边界上对齐:
新增有效 Global payload 加 scale 为:
它恰好等于 。但这不等于请求总成本只有 3560 bytes:还要读取已缓存的 Global memory、重建局部状态、执行 MoE、处理临时 activation,并可能发生网络加载。
12.6 粗粒度 token-layer 工作量
在上述 miss 路径,忽略其他开销的示意计数为:
如果错误地只按 suffix 算,会得到:
两者差别说明调度器不能只看 uncached suffix 长度。这里不是性能实测,也不能直接用两者之比预测延迟;实际单层、索引、batch 和通信成本仍需建模。
13. PD 分离和 EPD 分离
13.1 PD 是工作负载切分,不是模型层切分
Prefill 更容易形成大量 token 的矩阵计算,Decode 通常每条活跃序列只推进一个或少量位置,两者在计算效率、延迟要求和资源瓶颈上不同。
PD 分离把这两类工作分配给不同资源池:
两个 worker 可以采用不同的 batch、并行度和执行配置,但都要具备各自阶段所需的模型能力。D worker 的一个正常 Decode step 仍包含 L0–L39。
如果把 L0–L19 永久放在机器 A、L20–L39 放在机器 B,让每个生成 token 都依次跨两台机器,那么是在做模型 pipeline parallelism。它可以和 PD 结合,但不等于 PD 本身。
13.2 EPD 多加的一段是什么
对于图文请求:
E 向 P 提供视觉 embeddings 及布局、位置等必要信息,而不是提供已经完成整个语言模型计算的 KV。
长图像、纯文本、短问答的资源需求不同,把视觉处理独立出来可以单独扩容和调度。对于纯文本请求,可以不经过视觉计算阶段。
13.3 三种并行可以同时存在
| 名称 | 切分轴 | 主要对象 |
|---|---|---|
| EPD / PD disaggregation | 请求的执行阶段 | 视觉、Prefill、Decode 资源池 |
| Pipeline Parallelism | 模型层 / stage | 相邻模型层的 activation 和共享状态 |
| Tensor / Expert Parallelism | 算子或专家 | 权重、张量、专家 token dispatch |
不能用同一张简化架构图上的左右两个框,同时推定这三类切分的边界。
13.4 为什么要分离,付出什么代价
收益包括:
- 长 prompt 的 Prefill 不直接占用 Decode worker 的完整执行轮次;
- 两类 worker 分别选择适合自己的 batch 和并行配置;
- 长输入和长输出请求比例变化时可以分别扩容;
- 视觉处理可与其他请求的语言计算重叠。
代价包括:
- P→D 的状态传输和必要的格式转换;
- 请求接力时的 ready barrier;
- prefix cache 放置和 D worker 选择更复杂;
- 相同 HBM、网络或存储资源仍可能产生争用;
- 如果 P 和 D 的 TP/EP 布局不同,还要考虑 resharding。
所以 PD 不是“加一条网络线就一定更快”。在缓存较小、请求很短或网络拥塞时,交接开销可能抵消隔离收益。
报告确认使用 EPD,但并未公开所有 worker 拓扑、P→D 消息字段和数据传输调度。下两章明确按工程依赖推导展开,不将其写成未经公开验证的官方实现。
14. P→D 交接必须携带什么
14.1 第一原则:D 必须能从交接边界继续正确执行
一种由依赖关系推导的逻辑状态包为:
其中:
- :三个 Encoder Global sources;
- :一个 Decoder Global source;
- :二十层 Encoder SWA;
- :二十层 Decoder SWA;
- :未完成的 Encoder compression tail;
- :长度、位置、页表、有效范围和其他运行元数据;
- :如果 P 已采样第一个 token,还需交给 D 消费。
这不是要求所有对象必须在一个网络包中完整复制。若 D 已经持有相同 prefix,可以传引用、所有权和缺失增量;若 replay 在 D 进行,则要传能在 D 重建相关状态的数据,而不是已经完成的 。
14.2 各类数据为什么必要
| 对象 | 缺失会发生什么 | 可选恢复或优化 |
|---|---|---|
| Encoder Global | Encoder Full 无法检索完整历史 | 从共享缓存加载已有 prefix,P 仅传新增部分 |
| Decoder Global | L20 全局索引和各层稀疏读取缺数据 | 同上,或执行等价的生成/加载流程 |
| Indexer K | 无法选择需要读取的 Main entries | 从 source 正确生成或加载,不可用 Top-K 永久替代 |
| Encoder SWA | 续跑缺少局部历史 | 交接现有状态或 replay |
| Decoder SWA | 首个 Decode 的局部依赖不完整 | P 已重建后传输,或 D 有输入后自行重建 |
| Compressor tail | 奇数边界的下一组无法正确完成 | 传 tail、对齐边界或按约定恢复 |
| 绝对位置 / 有效长度 | RoPE、mask、append 位置可能错误 | 必须显式维护 |
| 量化 scale / layout | payload 无法正确解释 | 随条目传输或遵守统一编码格式 |
Engram 的下一个 n-gram 地址还依赖近期 token IDs。D 需要这些 token 历史或相应 n-gram 状态;这不是传输整张 Engram 参数表。
14.3 为什么不能只把 Top-512 传给 D
Top-K 是某个 query 的选择。下一个生成 token 的 query 不同,可能访问完全不同的历史位置;L20 也需要对全局 Indexer K 做初筛。
因此,不能因为当前 core attention 只读取约 640 个 entry,就推断每个请求只需转移最后选中的 512 个 Global entries。
若设计 remote KV、按需拉取或分布式 indexer,那是额外的系统方案,需要分析远程随机访问、索引放置、命中率和首个 ITL,不是 CSA2 架构自动提供的功能。
14.4 哪些东西通常不用为下一 token 持久交接
当 P 的最后一次 forward 已完成,没有尚未结束的消费者时:
- 已完成 query 的 Top-K 可以释放;
- 已完成 query 的 Candidate Pool 可以释放;
- 大部分中间 hidden 和 mHC activation 可以释放;
- 不需要给每个 Reuse 层复制同一个 Global source。
若是在某次 forward 中途迁移,情况会不同;本章讨论的是标准阶段边界交接。
14.5 量化与跨并行布局的影响
Global Main KV 与 Indexer K 的 FP4 payload 和 scales 是一个整体。不同 worker 应对条目编号、压缩组位置、page size、scale layout、对齐规则达成一致。
如果 P、D 并行布局不同,源端分片不一定能直接成为目标端 kernel 的输入。传输时间模型至少应区分:
它是分解模型,不是各项总能完全相加的精确执行时间;部分转换可以与传输重叠。
14.6 百万上下文的传输规模
若所有 Global 状态都缺失, 时,仅 Global payload 和 scales 约为:
还有 SWA、tail 和元数据。这解释了 cache 压缩为什么不仅帮助显存容量,也会影响 PD 网络流量和存储加载时间。
但如果 D 已经持有相同的长 prefix,真正需要转移的是缺失部分。路由必须知道状态位置和版本,而不只是选择当前队列最短的 D worker。
14.7 Ready barrier 与所有权
开始下一步 Decode 前,需要保证:
- 目标所需 Global pages 到齐,长度和 causal 可见范围一致。
- Encoder/Decoder 局部状态对应同一个已处理边界。
- Compressor tail 的边界与 Global 完成条目数一致。
- sampled-but-not-consumed token 的状态明确。
- 异步 copy、layout conversion、replay 已通过 event 或等价同步完成。
源端不能在传输仍读取 ring buffer 时覆盖它;目标端不能把未完成压缩组当作已发布的完整 entry。共享 prefix 页面应保持只读,新增 suffix 通过独立页或 copy-on-write 管理。这些是状态一致性的工程要求,不是模型图上画出共享箭头就自动成立。
15. 请求级流水线与单请求分块流水线
15.1 第一种:不同请求重叠
图 6:请求级 EPD 流水线——A 生成时 B 继续准备与 Prefill
下面恢复此前的时序图。纵向表示执行先后,par / and 表示两条可重叠的工作分支,不是它们必须同时开始或恰好同时结束。
逐段解释:
- A 的视觉 embeddings 到达 P 后,P 完成所需 Encoder Prefill 和 Decoder replay。
- A 的 cache 与请求状态在 D 就绪后,D 开始生成并向用户流式输出。
- 与 A 的 Decode 重叠,E 和 P 为请求 B 处理图像与 prompt。这样新请求的长 Prefill 不必直接占据 A 所在 D worker 的整个执行轮次。
- B 的状态就绪后,D 可在合法调度边界将它接入 continuous batch,与仍未完成的 A 共同执行。
- 图中没有画出所有 queue、cache-load 和网络同步;共享网络、存储或内存带宽仍可能产生争用,不能从
par推导出完全无干扰。
这是一条跨请求流水线。它不意味着一个请求的 Encoder 和 Decoder 两半可以忽略依赖任意并行。
一个阶段示例:
| 时间片 | E 资源池 | P 资源池 | D 资源池 |
|---|---|---|---|
| 请求 C 的图像编码 | 请求 B 的 Prefill | 请求 A 的持续 Decode | |
| 请求 D 的图像编码 | 请求 C 的 Prefill | A 与已接入的 B 组成 Decode batch | |
| 后续请求的图像编码 | 请求 D 的 Prefill | 持续合批、完成、移出与接入 |
这是一条多请求流水线。并不是必须等 A 生成完,B 才能开始 Prefill。
Decode 侧 continuous batching 在执行边界接入准备好的请求,移除已结束请求;具体是否混入 prefill、如何调度 verifier,取决于 serving engine。
15.2 第二种:一个长请求内部重叠计算与传输
图 7:单请求分块流水线——后续 chunk 计算与已完成 KV 传输重叠
下面恢复此前的单请求时序图。它描述一种可行的工程安排:P 一边继续长 prompt 计算,一边把已完成的 Global blocks 送往 D;不是对官方生产协议的逐字段复刻。
逐段解释:
- Encoder chunk 1 产生可发布的 Global blocks 后,可以开始发送;其中 Decoder Global blocks 还需等待相应 Encoder outputs 完成投影。
- chunk 2 计算可以与前面 blocks 的传输重叠。KV 传输 lane 表示异步拷贝/通信工作,不强制要求单独一台“传输服务器”。
- 未完成的 ratio-2 压缩组不能当作完整 Global entry 发布,需保留其 tail 或等待下一 chunk 凑齐。
- 最后的 Decoder replay 为各层建立局部状态;随后还要交接最终 SWA、压缩尾部、长度和状态版本。
- D 的 ready 必须以全部必要依赖一致为前提。只有收到部分 Global blocks,尚不足以开始基于完整 prompt 的正常生成。
- 活跃 SWA ring 是会覆盖的状态,不能在异步传输读取时随意修改。需采用 snapshot、同步或等价机制,保证接收端拿到同一边界的状态。
图中把 Decoder replay 放在 P,是用于解释流水线的一种选择;放在 D 的取舍见第 15.6 节。
设 prompt 被切成 chunks:
一种可行的依赖顺序是:
- 处理 chunk 的 Encoder,形成可发布的 Encoder Global entries。
- 其 Encoder outputs 就绪后,投影对应的 Decoder Global entries。
- 将已完成的 Global pages 异步传给目标 D,或写入两端可访问的缓存。
- P 同时继续 chunk 、chunk 的计算。
- 保留最终尾窗所需的 Encoder outputs。
- 全 prompt 的依赖就绪后,完成 Decoder bounded replay 和最后位置输出。
- 传输或重建最终 SWA、tail、metadata,并通过 ready barrier。
- D 开始消费待输入 token。
每个 Encoder chunk 仍受前面 chunk 的 causal state 约束,不能把所有 chunks 当成互相独立的短请求任意并行。上述方案是流水重叠,不是消除因果依赖。
15.3 ratio-2 边界如何处理
若 chunk 结束位置是奇数,最后一个 projected token 仍属于未完成压缩组。它应该留在 tail state 中,等下一 chunk 的第一项到来后再发布完整 Global entry。
可采用偶数边界对齐减少这种情况,但 padding、packed requests、prefix-hit boundary 和 speculation 都可能重新引入不整齐边界,因此系统仍应显式支持 tail。
Global entry 是否完整,与它所在的物理 page 是否填满也不是同一问题:前者决定语义合法性,后者决定 allocator 的传输和持久化粒度。
15.4 SWA 为什么不适合直接按 Global 的 append-only 方式传
Global 完整条目通常不断追加,已提交 prefix 可以保持不可变;SWA ring 不断覆盖旧槽位。
如果网络在读取某个 ring snapshot 时,新一轮执行修改同一槽位,目标可能收到混合时间点的状态。实现需使用 snapshot buffer、版本管理、双缓冲或同步,不能直接把活跃 ring 的地址交给异步传输后继续任意覆盖。
15.5 哪些延迟能隐藏,哪些不能
可重叠的部分包括:前面 chunks 的 Global 传输与后面 chunks 的计算、缓存加载与输入准备、Engram 预取与 backbone 计算、不同请求间的 E/P/D 工作。
无法凭空隐藏的部分包括:最后所需状态尚未生成的时间、最后的目标就绪检查、当前请求必须完成的尾窗 replay,以及目标 Decode 队列等待。
理想化看,bulk 阶段更接近:
然后还有 final dependencies。实际可能因为共享内存带宽、网络争用或不均匀 chunk 而达不到这个理想重叠。
不能在完整 prompt 还没处理完、必要上下文尚不可见时,就按“已经有部分 Global pages”生成本应基于完整 prompt 的第一个回答 token。
15.6 Replay 应放在 P 还是 D
架构上两种方式都可讨论:
- P 完成 Decoder replay,再把可直接续跑的状态交给 D;
- P 提供 Global memory 和所需 Encoder tail outputs,由 D 重建 Decoder SWA。
前者减少 D 的初始化计算,但增加部分状态传输;后者改变传输对象和 Decode 资源池的工作类型,可能干扰其他请求 ITL。
需要比较实际 activation/state bytes、计算排队、可重叠程度和 cache residency。报告没有给出足够细节,让我们把其中一种写成唯一官方实现。
16. TTFT、首个 ITL 与稳态 Decode
16.1 三个指标应分别看
- TTFT:请求进入到第一个输出 token 可交付的时间。
- 首个 ITL:第一个输出 token 到第二个输出 token 的间隔。
- 稳态 ITL:已经接入 Decode batch 后,后续 token 的典型间隔。
PD 交接可能影响 TTFT,也可能主要落到首个 ITL,取决于第一个 token 在哪里采样和交付。
16.2 若 P 产生并交付第一个 token
串行化的示意分解为:
各项可能重叠,因此应以实际关键路径计时。交付首 token 后,如果状态还没有在 D 准备好,则第一个 token gap 还会受到:
的影响。系统不能只展示较好的 TTFT,却忽略首个 ITL 的明显停顿。
16.3 若 D 才交付第一个 token
必要的 P→D 交接会进入 TTFT 的关键路径。这样指标呈现不同,但依赖本身没有消失。
因此评估 PD、bounded replay 或缓存方案时,应说明:首 token 的采样和交付位置、handoff 是否包含在测量中、是否区分首个与稳态 ITL。
16.4 为什么高 prefix 命中率不必然意味着低 TTFT
长 prefix 即使不重算,也可能需要从 SSD 或远端加载;Encoder SWA 可能 miss;Decoder 仍要重放尾窗;目标 D 的缓存放置和排队也可能不理想。
应把 cache hit 拆成“免计算的字节”和“已经在正确设备上的字节”,并显式记录 replay 工作量。只用 token hit ratio 解释延迟容易遗漏主要开销。
17. DSpark 与推测状态管理
17.1 草稿与验证的流水线
语义上可分成:
- Drafter 根据已接受上下文产生最多五个位置的草稿分布。
- Markov head 建模草稿内部依赖,形成候选序列。
- Confidence head 估计接受概率。
- Scheduler 结合负载与吞吐 profile 选择验证长度。
- 主模型对所选草稿进行验证。
- 按算法接受连续前缀,提交相应状态,处理拒绝和修正。
“一个 token 经过完整 40 层”适用于普通逐步 Decode 的解释。Speculative verification 可以在一次 forward 中处理多个候选位置,但没有免除主模型验证。
17.2 为什么最大草稿长度不一定最优
设位置 的条件接受概率为 ,连续前缀存活概率的示意估计为:
验证 个位置时,期望接受的草稿数为:
调度目标可抽象成:
分子不直接等同于 ,因为具体验证算法还可能提交修正 token 或额外 token。这个公式是帮助理解的成本模型,不是声称报告使用这一模一样的解析表达式。
长草稿接受率低时,额外验证会浪费工作;负载很高时,它还会挤占其他请求的 batch 预算。报告因此把 confidence 与实际 engine throughput curve 联合使用。
17.3 CSA2 的 speculative state 不止一个 KV 长度
如果验证过程产生了后续几个候选位置的状态,则可能同时修改:
- 四个 Global sources 的追加区;
- 四十层 SWA ring;
- 三个 Encoder compressor tails;
- DSpark 自己的局部状态;
- accepted length、位置和采样相关元数据。
只将 Global valid length 回退,未必足以恢复整个请求状态:SWA ring 可能已经覆盖旧槽位;ratio-2 压缩组可能把一个接受 token 和一个拒绝 token 合在一起。
例如,原边界后草稿为 ,两个位置本来组成一个 compressed entry,最终只接受 。正确提交状态应是: 留在未完成 tail,而包含 的完整 entry 不能成为已接受 Global memory。
17.4 可行的工程策略
可考虑 checkpoint/restore、临时 speculative buffers、延迟提交、保留环形槽位旧值,或只对必要的接受边界重算。具体选择取决于状态大小、kernel 设计和接受率。
这些是由架构推出来的状态管理要求,不是报告公开了某一个确定的 rollback 算法。公开参考实现也不能自动被当作完整支持并发请求、任意回滚和 PD 迁移的生产运行时。
18. 缓存容量、HBM 流量和吞吐成本
18.1 一份 Global KV 不代表只读一次
20 个 Decoder 层共享一份 memory,显著降低持久占用,但每层仍会根据自己的 Main Q 读取选中 entries,并计算不同的结果。
即使几层 Top-K 一样,也不保证数据一直驻留片上缓存。是否命中 L2,受到 batch、层间 kernel、MoE 工作集、调度顺序、GPU 架构等影响。
因此以下推理不成立:
正确理解是:减少了容量与重复写入,并创造跨层数据重用机会;具体流量收益需 profile。
18.2 单轮执行中的主要流量
至少包括:
- Full 层 Global/Indexer 新条目的生成、量化与写入。
- Indexer 对完整 history 或 candidates 的读取。
- 各层主 attention 对 selected Global 与 SWA 的读取。
- 每层 SWA ring 的更新。
- MoE 权重与 token dispatch/combine。
- mHC residual activation 的读写。
- Engram 查表、预取与使用。
- Prefill replay 和 cache loading。
- PD 传输、布局转换和 speculative 临时状态。
CSA2 主要压缩前面几项中的一部分,Single-Pass mHC 优化另一部分,Engram 和 MoE 又引入自己的访存/通信行为。这正是必须从整体模型分析,而不是只计算 的原因。
18.3 简化执行成本模型
对一轮 batch,可以把时间估计写成:
或者把资源需求拆成:
这是系统分析框架,不是精确闭式模型。执行时间还取决于重叠、并行效率和 kernel 启动成本,不能简单把所有 bytes 除以峰值带宽再相加。
18.4 Continuous batching 要关心哪些状态
Batch scheduler 除了判断内存能否容纳请求,还应知道:
- 新接入请求是否需要恢复 Encoder SWA;
- Decoder 尾窗是否已经完成;
- Global cache 已在 HBM,还是仍在远端/SSD;
- 本轮是普通一步 Decode,还是多位置 verify;
- 下一步是否完成 ratio-2 压缩组;
- D worker 的 prefix locality 与网络负载;
- TTFT / ITL 的剩余时限。
四个 Global sources 的容量模型、四十个局部 ring 的状态模型和 query-local routing 的执行模型必须分开管理。
18.5 可研究的系统方向及其边界
从这套架构可提出以下工程研究问题:
- 按恢复成本与到达间隔决定 Encoder SWA 的短期驻留,而不只按 LRU。
- 联合选择 D worker、Global prefix 放置和 P→D 缺失增量传输。
- 对 replay、普通 Decode 和 speculative verify 建立不同的 round-time 预测。
- 优化同一个 Global source 在相邻消费者间的片上复用,但必须保留 hidden 依赖。
- 联合置信度、验算成本与 cache commit/rollback 成本选择 DSpark 验证长度。
- 在 TTFT 与首个 ITL 约束下决定 replay 放置和传输重叠。
这些属于可行方向,不意味着已有论文贡献已经完成。若要形成方法,需要明确基线、实现边界、质量约束、SLO 指标和真实负载评测。尤其不能把近似 replay 的质量风险当作纯粹系统层可忽略的误差。
19. 代码阅读、Kernel 与并行运行时
19.1 先读配置,再读对象所有权
官方配置中的关键字段包括:
1 | n_layers = 40 |
据此可推导 mode:
1 | if layer_id in kv_source_layers: |
完整 compressor、indexer 和三种 mode 的教学代码保留在附录 A。代码中的单个 shared 是表达 source–consumer 关系的简化,不可直接拿来管理所有并发请求。
19.2 模型级 Prefill 控制流示意
1 | def cold_prefill(prompt, request_state): |
该代码突出“全部位置投影 Global,尾窗位置执行 Decoder”的分工。它省略了 batching、mHC stream 表示、量化、mask、MoE 并行和异步事件。生产实现也可以把某些操作融合在 L20 内,而不是建立上述函数名。
关键不变量是:一个位置的 Decoder Global entry 只追加一次,不能投影阶段追加一次、replay 再追加一次。
19.3 带 prefix hit 的恢复控制流示意
1 | def resume_prefill(tokens, hit, state): |
obtain_encoder_outputs 是显式标出的数据依赖,不是公开报告已提供一个可直接调用的实现。缓存对象里只有 Global KV 时,不能假装它能无成本返回原 。
19.4 普通 Decode 示意
1 | def decode_step(input_token, state): |
19.5 公开参考实现与生产路径的差别
报告的 production optimization 不等于公开 Python 中已实现全部同等性能路径:
- 参考 hierarchical indexer 可先算完整 score,再 mask 候选;数值语义正确,但不节省完整 GEMM。生产要先 compact/gather candidates,再计算其分数。
- FP4 参考路径可能通过 quantize/dequantize 模拟数值,attention 接口仍用浮点 tensor;这不是完整 packed FP4 paged allocator。
torch.topk与 production DeepSelect 的性能不能等同。- 单次 forward 的共享 runtime 不等于支持多请求并发、speculation、PP 和迁移的状态系统。
- 模型参考代码不能作为“某个版本 SGLang 已具备完整 PD、persistent cache、bounded replay 支持”的证据;那需要单独审查对应引擎版本。
19.6 Kernel 层面应如何读图
图中的多个方框可以被融合到一个 kernel;一个方框也可能由多个 kernel 完成。逻辑模块边界不等于 GPU launch 边界。
报告提到的生产优化包括 FlashMLA 的 RoPE–Attention–inverse RoPE–cast 融合,DeepGEMM 的 Mega-Gate、Mega-mHC、Mega-MoE,TileKernels,以及 DeepSelect TopK。Reuse mode 避免 compressor 和 indexer,报告给出每层 Prefill 15 个 kernels、Decode 11 个 kernels 的实现结果。
这些数字对应所述实现和统计口径,不是任何硬件或第三方框架都自动达到的固定值。
Sparse attention 可按 int32 indices 直接 gather,通过 online softmax 融合归一化,不必物化新的 selected-KV cache。Main KV 同时作为 value,partial RoPE 后的 attention output 还要做相应逆位置旋转,再经过 grouped output projection。
19.7 分布式运行时的所有权
跨 stage 的 Full source 和 Reuse consumer 需要约定共享状态的生命周期。训练报告给出的机制包括 shadow indexers、扩展 pipeline payload、microbatch-level shared-state manager;它们同时处理 forward、activation recomputation 和 backward 中的使用。
推理中也必须为 request、batch、stage、query 和 speculative branch 隔离状态。一个请求的 Top-K 覆盖另一个请求的 Top-K,不是数值近似问题,而是执行正确性错误。
Context Parallelism 切序列时,还要处理压缩组跨分片边界和 packed sequence 边界。V4 的大压缩窗口处理更复杂,CSA2 的非重叠 ratio-2 简化了状态,但并未取消边界问题。附录 A 保留该部分对照。
参考阅读:model.py、kernel.py、README。这些链接随官方分支更新可能变化,分析应结合具体配置和版本。
20. 全部追问的逐项回答与易错点
20.1 “为什么每层都有 SWA?”
前两层是 SWA-only,后面 CSA2 内部也包含 SWA。每层都要从自己的 hidden 生成局部 KV,保留局部计算深度和近期细节。Global 共享并不替代这一条逐层局部路径。详见第 3、5 章。
20.2 “ratio=2 就是 1024 变 512,对吗?尾部又是什么?”
对,每个 Encoder source 为 512 个完整 entry。若已经处理 1025 个位置,则只有 512 个完整 entry,另外一项 projected value/gate 暂存在未完成组里;这才是 compression tail。详见第 6 章。
20.3 “ 的 C 和 D 是什么?”
是 Main KV latent 集合, 是 Decoder 的标记; 是 Decoder memory 对应的 Indexer K,不是同一用途的另一份 Main KV。详见第 6.5 节。
20.4 “Encoder 和 Decoder 各维护 Global Pool?”
逻辑上 Encoder 三份,Decoder 一份,每份含 Main KV 和 Indexer K。物理上可由同一个分配器管理。Decoder pool 是从 Encoder final hidden 投影出来的新表示,不是直接复用三份 Encoder source 的同一字节。详见第 6.6 节。
20.5 “Encoder 后为什么只保留 128?”
只让最后最多 128 个 query outputs 继续通过 Decoder 主体;全序列信息已经进入 Decoder Global KV。不是把历史 context 删除到 128 项。详见第 7 章。
20.6 “128 是静态的?”
模型 window size 配置为 128;短序列 replay 取 。它不随 Top-K 动态挑选,也不能任意修改后保证质量和原语义不变。详见第 7.6 节。
20.7 “Prefill 会像 YOCO 一样只执行一层吗?”
不是。要区分 query 位置数与层数:V4.1 全部 prompt 过 20 层 Encoder,尾窗过 20 层 Decoder。YOCO 的相关省算也不是只执行上半模型一层。详见第 9 章。
20.8 “Decoder 的 KV 都不会缓存吗?”
Decoder Global KV 会保留并用于 prefix 复用。Decoder SWA 会在当前 Decode 中保留,但不进入跨请求 prefix cache,每次 Prefill 重建。不能把 Global 与 SWA 混称“Decoder KV”。详见第 10 章。
20.9 “只有 Encoder 的 KV 能持久化?”
不是。两边的 Global KV 都可持久化;Encoder SWA 采用短期复用池,Decoder SWA 是当前生成状态。分类轴是 Global/SWA 与长期/短期/运行时,不只是 Encoder/Decoder。详见第 10 章。
20.10 “Global 是跨层,SWA 是当前层?”
在本模型中可以这么概括所有权,但 Global 一词本身描述长程覆盖。更准确的是“Global 是 source-owned 并跨层共享,SWA 是 layer-owned”。详见第 5.1、5.8 节。
20.11 “最近 128 会不会冗余?”
可能覆盖同一原始位置,但不是同一个向量。Global 来自共享 source,SWA 来自当前层;投影、计算深度、压缩方式和精度都可能不同。这种多表示覆盖不等同于可删除的字节重复。详见第 5.4 节。
20.12 “拼接是把维度加宽吗?”
不是。最多 的 selected Global 与 的 local memory,沿 entry 轴形成 ,再做共同 softmax;可以在 kernel 中逻辑拼接,无须真的复制。详见第 5.5、5.6 节。
20.13 “为什么 SWA 不能引用 Global 的最后 128 个 token?”
因为所需张量不相同;深层 SWA 不能从共享浅层 Global 无损恢复。即使 Decoder ratio 为一,逐 token 对应也不等于逐向量相同。改成共用需要模型改造和质量验证。详见第 5.7 节。
20.14 “Global 不是所有层都存了吗?”
不是。所有 CSA2 层都能读对应 Global source,但只有 L2、L8、L14、L20 是生产者/逻辑存储来源。其余层引用它,不建立独立完整副本。详见第 3 章。
20.15 “既然 Reuse,层能并行吗?”
相邻层的 query 仍依赖前一层 hidden,因此不能把这条序列的所有层直接并行计算。可并行的是其他请求、batch 内位置的合适算子、不同流水段中的不同 microbatches。详见第 3.3 节。
20.16 “Global cache 命中后只算 suffix 就行?”
不一定。可能需要恢复 Encoder SWA,而且 Decoder 仍要重建完整 prompt 尾窗。suffix 只有四项时,也可能需要 128 项 Decoder replay。详见第 11、12 章。
20.17 “PD 就是左边 Encoder 放 P,右边 Decoder 放 D?”
不是。PD 按 Prefill/Decode 阶段分资源,D 的每个新 token 仍跑完整模型。左右模型层拆机器属于 PP,可以与 PD 组合但不是同一概念。详见第 13 章。
20.18 “KV 压缩这么多,计算和 HBM 流量也同比例减少?”
不能这样等同。Global capacity、索引次数、读取条目数、跨层实际复用和 MoE/activation 成本是不同账本。尤其不能把二十层一份 Global memory 写成必然二十倍读取加速。详见第 18 章。
20.19 用一条完整链条重新理解这个模型
长输入首先通过较浅的 Causal Encoder 建立可复用的全局记忆;Decoder 用 Encoder final hidden 建立一座逐 token 可检索的共享记忆库,仅对尾窗补算局部深层状态。生成时,每个新 token 仍完整经过四十层,一边更新局部窗口和少量全局 source,一边通过不同深度的 query 读取共享历史。系统把可长期复用的 Global KV 与短命的局部状态分开存储,必要时以近似 replay 换存储;PD/EPD 再把输入处理和生成阶段分资源调度,DSpark 用草稿与验证减少自回归轮次。
这套设计的关键不是单一的“压缩 token”,而是分别控制计算深度、记忆表示、共享范围、检索频率、状态生命周期和数据移动。
附录 A:原 CSA/HCA/CSA2 专题的完整技术展开
本附录保留旧专题第 1–23 章的技术内容、公式、示意图和代码,不以正文已有概要为由删减。为适应新文档,编号加上 A 前缀;仅校正“另外四处但实际列出五项”、SWA 临时张量与持久窗口的区别、 的单位、以及冷 Prefill 与 prefix-hit Prefill 的适用边界。原始 Markdown 文件不作修改。
阅读本附录时,具体模型和部署边界以正文为准:教学代码省略归一化、位置、因果 mask 或并发管理时,不代表生产可以省略;Decoder SWA 不做 prefix caching,不代表 Decoder Global 不能持久化。
A.1. 一句话结论
DeepSeek-V4 的全局注意力由两种层交替构成:
- CSA:小倍率序列压缩 + 稀疏 Top-K 检索;
- HCA:大倍率序列压缩 + 对压缩结果做稠密 attention。
DeepSeek-V4.1 取消 HCA,改成纯 CSA2。CSA2 同时在三个维度压缩长期全局 KV:
- Entry 维度:64 个 Query head 共享一个 512 维 Main KV latent;
- Sequence 维度:Encoder 每 2 个 token 压成 1 个 Main KV entry;
- Layer 维度:38 个 CSA2 层实际只建立 4 份 global KV cache。
另外:
- 只有少数层重新运行 indexer;
- 大部分层复用上游层的 Top-K;
- Decoder 后续 indexer 只在最多 16,384 个候选位置中搜索;
- CED 让绝大多数 prompt token 只经过下半个模型;
- SWA state 不进入长期 persistent prefix cache;Encoder SWA 可短期复用,Decoder SWA 每次 Prefill 重建,活跃 Decode 期间仍需保留。
因此 CSA2 的重点绝不只是“每几个 token 压成一个 token”,而是:
把 global memory 的内容、索引结构、访问位置和局部状态拆开,并赋予它们不同的生成频率、共享范围、精度和生命周期。
A.2. 先建立 MLA、DSA、CSA 的坐标系
设上下文长度为 ,模型层数为 。
A.2.1 MLA 压缩的是每个位置的 KV 宽度
普通 MHA 对每个 token、每一层保存很多个 KV head:
MLA 将每个位置的 KV 压缩为一个较小的 latent:
所以 MLA 主要压缩的是:
但是位置数量没有变:
如果仍然对全部位置做 dense attention,那么每个 Decode token 仍需要扫描 个位置。
A.2.2 DSA 压缩的是实际参与主 Attention 的位置数
DSA 增加一个低成本 indexer:
- 用低维 Indexer Q/K 给历史位置打分;
- 从 个位置中选择 Top-;
- 真正昂贵的主 attention 只访问这 个位置。
但是 DSA 通常仍然需要:
- 保存每个历史位置的 Main KV;
- 保存每个历史位置的 Indexer K;
- 让 indexer 扫描很长的上下文。
所以 DSA 主要降低 core attention FLOPs,不会自动等比例降低 KV cache 与 indexer 扫描成本。
A.2.3 CSA 在 DSA 之前再做一次序列压缩
CSA 首先执行:
再从 个压缩位置中选择 Top-:
因此可以把三者理解成:
| 方法 | 压缩的主要对象 |
|---|---|
| MLA | 每个 token 的 KV 宽度或 head 维度 |
| DSA | 真正参与主 attention 的历史位置数量 |
| CSA | 先压缩历史位置数量,再进行 DSA Top-K |
| CSA2 | 在 MLA/DSA/CSA 的基础上继续压缩 layer 维度,并复用索引 |
A.3. DeepSeek-V4 的 CSA
A.3.1 总体数据流
V4-Flash 中:
- CSA compression ratio:;
- attention Top-K:512;
- SWA window:;
- Main Query heads:64;
- Main head dimension:512;
- Indexer heads:64;
- Indexer head dimension:128。
V4-Pro 的 CSA 同样使用 ,但 Top-K 为 1024。
A.3.2 V4 CSA 的 Compressor
输入为:
CSA 生成两套 KV 与两套 gate:
其中:
第 个 compressed entry 使用:
- 当前 block 的 个 ;
- 前一个 block 的 个 。
权重来自:
这里需要注意三件事。
权重是逐 channel 的
每个 都是一个 维向量。因此并非“一个 token 只有一个标量权重”,而是每个 channel 都有独立的 token 权重:
不同 KV channel 可以从 block 内不同 token 中提取信息。这比 mean pooling 或单标量 attention pooling 更有表达力。
每个输出覆盖 个 token,但输出 stride 是
一个原始 block 会通过:
- 进入当前 compressed entry;
- 进入下一个 compressed entry。
所以相邻 compressed entry 存在信息重叠,但最终仍只产生 个 entry。
Compressor 内有 block 位置 bias
用于告诉 pooling:当前值位于压缩窗口的哪个槽位。CSA2 后来把这部分删除了。
A.3.3 Lightning Indexer
CSA 不直接使用 512 维 Main KV 扫描全部压缩位置,而是建立较小的 Indexer K:
V4 中,Indexer K 有一条独立 compressor 路径。对于 query token :
Indexer 分数为:
其中每个 indexer head 的组合权重由当前 query hidden state 预测:
最后:
主 attention 只读取 对应的 Main KV。
A.3.4 Shared Key-Value MQA
一个 compressed latent 同时充当 Key 与 Value:
即:
64 个 Query head 共享同一份 512 维 KV latent。这样压缩了 KV cache,但 64 个 Query head 的输出拼接后宽度达到:
所以 V4 采用 Grouped Output Projection:先将 heads 分组、每组降维,再统一映射回模型 hidden dimension。
A.3.5 为什么还需要 SWA
Compressed entry 只有在整个 block 完成后才能安全地对 query 可见。
例如 时,token 0、1、2、3 形成一个 entry。对于 token 0、1、2,如果提前读取这个 entry,就会间接看到未来 token,违反因果性。
因此每层额外保留最近 个未压缩 SWA KV:
SWA 的作用包括:
- 覆盖当前未完成的 compression block;
- 保留最近 token 的高精度信息;
- 补偿压缩导致的局部细节损失;
- 维持严格 causal semantics。
A.4. DeepSeek-V4 的 HCA
HCA 是 Heavily Compressed Attention,不要和 mHC 混淆。
V4 中:
一百万 token 被压缩为大约:
个 HCA entry。
HCA 不使用 indexer,也不做 Top-K,而是让 query 稠密访问全部 HCA entry,计算复杂度为:
HCA compressor 是非重叠形式:
它同样是逐 channel learned pooling,但压缩率远大于 CSA。
A.5. 为什么 V4 要把 CSA 和 HCA 交替使用
| 机制 | 序列压缩率 | 全局访问方式 | 优点 | 缺点 |
|---|---|---|---|---|
| CSA | Indexer Top-K | 粒度较细,可以定位精确信息 | Indexer 仍要扫描长上下文,存在选择错误 | |
| HCA | Dense over compressed entries | 不依赖 Top-K,始终覆盖全部全局摘要 | 每个 entry 很粗糙 | |
| SWA | 不压缩 | 最近 128 token | 局部精确、因果安全 | 不能覆盖远距离历史 |
可以把 V4 理解成:
- CSA:稀疏但较精细的远程记忆;
- HCA:稠密但粗粒度的全局摘要;
- SWA:精确的近期记忆。
V4-Flash 前两层是纯 SWA,之后 CSA/HCA 交替;V4-Pro 前两层使用 HCA,后续继续交替。
A.6. 从 CSA 到 CSA2:到底改了什么
CSA2 不是简单地把 compression ratio 换成另一个数字。它主要包含四项变化。
A.6.1 Main Compressor 从双流重叠变成单流非重叠
V4 CSA:
- 两套 KV projection:;
- 两套 gate:;
- 每个输出覆盖 个 token;
- 相邻输出共享一个原始 block;
- 有 block 内 absolute positional bias。
CSA2:
- 一套 KV projection;
- 一套 gate;
- 每个输出只覆盖自己的 -token block;
- 相邻输出不重叠;
- 删除 compressor 内的 absolute positional bias。
A.6.2 Indexer K 从 Main KV 投影
V4 CSA:
CSA2:
即:
这消除了独立的 Indexer-K compression path。
A.6.3 Main KV 与 Indexer K 跨层共享
V4 基本上是每个 CSA/HCA 层保存自己的 global cache。CSA2 把多个层划成一组,只由 Full 层生成 global cache,后面的层共享它。
A.6.4 Top-K 也可以跨层共享
CSA2 将两个选择解耦:
- 要不要复用 KV;
- 要不要重新运行 indexer。
由此形成 Full、Reindex、Reuse 三种 mode。
A.7. 重点:CSA2 的 Compressor 为什么叫“简化”
A.7.1 用具体 token 看 V4 CSA
假设 ,输入 token 可以写为:
V4 CSA 的输出关系大致是:
图示如下:
因此:
- 每个正常输出聚合 个 projected source;
- 每个原始 block 通过两套参数进入相邻两个输出;
- Decode 时需要同时维护前一个 block 和当前未完成 block 的 state;
- gate 还要加入 block 内位置 bias。
它的优势是压缩边界更平滑,但实现和状态管理比较复杂。
A.7.2 CSA2 变成普通的非重叠 learned pooling
同样假设 :
其计算为:
仍需强调:这里不是普通平均池化。对于每个 channel ,都有独立的 个 softmax 权重。
A.7.3 “简化”具体减少了什么
| 项目 | V4 CSA | CSA2 |
|---|---|---|
| Main KV projection | 两套 | 一套 |
| Gate projection | 两套 | 一套 |
| 单个输出源范围 | ||
| 相邻输出重叠 | 有 | 无 |
| Compressor 位置 bias | 有 | 无 |
| Indexer K | 从 hidden 走独立 compressor | 从 Main KV 投影 |
| Decode tail state | 前一块 + 当前块,状态复杂 | 只维护当前未完成块 |
A.7.4 删除位置 bias 不等于删除所有位置信息
CSA2 删除的是 Compressor 内部的 block-slot absolute bias,不是删除整个 attention 的 RoPE。
压缩完成后:
- Main KV latent 仍会施加 partial RoPE;
- Indexer K 也有自己的 partial RoPE;
- 一个 compressed latent 在官方代码中使用该 group 第一个 token 的位置;
- 最近 128 个 token 仍由未压缩 SWA 保留细粒度顺序。
因此删除的是复杂的“窗口内部位置参数”,不是让模型完全不知道位置。
A.7.5 ratio=1 时 Compressor 退化为什么
Decoder 使用 。此时一个 group 只有一个 token:
再计算 gate 没有意义,所以直接退化为:
官方代码也只在 compress_ratio > 1 时创建 wgate。
A.8. 重点:Full、Reindex、Reuse 到底复用了什么
A.8.1 三种 Mode 的组件级数据流
| 当前层的行为 | Full | Reindex | Reuse |
|---|---|---|---|
| 计算自己的 Main Q | ✓ | ✓ | ✓ |
| 计算自己的 SWA KV | ✓ | ✓ | ✓ |
| 生成新的 Main KV | ✓ | 复用 | 复用 |
| 生成新的 Indexer K | ✓ | 复用 | 复用 |
| 生成自己的 Indexer Q | ✓ | ✓ | 不生成 |
| 运行 indexer | ✓ | ✓ | 不运行 |
| 生成新的 Top-K | ✓ | ✓ | 复用 |
| 执行 core attention | ✓ | ✓ | ✓ |
| 生成新的 attention output | ✓ | ✓ | ✓ |
A.8.2 把共享对象看成三条“状态总线”
这三类状态的来源不同:
- Main KV / Indexer K:只能由 Full 层更新;
- Top-K:Full 或 Reindex 层都可以更新;
- SWA KV:从不跨层共享,每一层都有自己的 local state。
A.8.3 一个 Decoder group 的实际例子
以 layer 24–27 为例:
四层使用同一份历史 Main KV,但它们不是执行相同的 attention:
- layer 24 用自己的 hidden 生成 Query,并重新选 Top-K;
- layer 25–27 各自生成不同的 Query;
- 即使 Top-K 相同,attention logits 和 attention output 仍不同;
- 每层的 SWA KV、输出投影、MoE 和 residual/mHC 也不同。
可以把 shared Main KV 想象成一座共享图书馆:
- Full 决定图书馆里存什么书;
- Reindex 使用自己的问题重新制作借阅清单;
- Reuse 沿用上一份借阅清单;
- 但每一层都会用自己的 Query 阅读这些书,并形成自己的新 hidden state。
A.8.4 为什么层仍然不能并行
第 层的 Query 来自第 层的输出:
所以 Main KV 和 Top-K 的复用只减少 cache 与索引计算,不会消除 hidden-state data dependency。Transformer layers 仍需顺序执行。
A.9. V4.1 的精确层布局
V4.1-Flash 有 40 层:
- 20 层 causal encoder;
- 20 层 decoder;
- 前两层只有 SWA;
- 其余 38 层使用 CSA2。
官方配置为:
1 | kv_source_layers = [2, 8, 14, 20] |
完整映射:
| 层 | 区域 | ratio | Mode | 作用 |
|---|---|---|---|---|
| 0–1 | Encoder | — | SWA only | 只有局部注意力 |
| 2 | Encoder | 2 | Full | 创建第 1 份 Encoder global KV |
| 3–7 | Encoder | 2 | Reuse | 复用 layer 2 的 KV 和 Top-K |
| 8 | Encoder | 2 | Full | 创建第 2 份 Encoder global KV |
| 9–13 | Encoder | 2 | Reuse | 复用 layer 8 |
| 14 | Encoder | 2 | Full | 创建第 3 份 Encoder global KV |
| 15–19 | Encoder | 2 | Reuse | 复用 layer 14 |
| 20 | Decoder | 1 | Full | 创建唯一 Decoder global KV 与 candidate pool |
| 21–23 | Decoder | 1 | Reuse | 复用 layer 20 |
| 24 | Decoder | 1 | Reindex | 在候选池内重新选 Top-K |
| 25–27 | Decoder | 1 | Reuse | 复用 layer 24 的 Top-K |
| 28 | Decoder | 1 | Reindex | 重新选 Top-K |
| 29–31 | Decoder | 1 | Reuse | 复用 layer 28 |
| 32 | Decoder | 1 | Reindex | 重新选 Top-K |
| 33–35 | Decoder | 1 | Reuse | 复用 layer 32 |
| 36 | Decoder | 1 | Reindex | 重新选 Top-K |
| 37–39 | Decoder | 1 | Reuse | 复用 layer 36 |
总计:
- 4 个 KV source;
- 8 个 index source;
- 30 个 Reuse CSA2 层;
- 2 个 SWA-only 层。
A.10. 重点:Decoder 中 ratio=1,没有压缩 token,收益在哪里
这是理解 CSA2 最关键的问题之一。
A.10.1 先给直接答案
Decoder 的 sequence dimension 确实没有压缩:
但它在另外五个地方获得了主要收益:
- Layer dimension:20 个 Decoder 层只保存 1 份 global KV;
- Entry dimension:每个位置只有一个 512 维 shared-KV latent,并使用 FP4;
- Attention compute:每层主 attention 只读取 Top-512 + SWA-128;
- Indexer compute:20 层中只有 5 层产生 Top-K,后 4 个只在 16K candidate 中搜索;
- CED Prefill:绝大多数 prompt token 不经过 Decoder 主体。
A.10.2 从三维 KV 张量看收益
把普通 Decoder global KV 抽象成:
CSA2 Decoder 的变化可以写成:
虽然 position 维仍是 ,但 layer 维从 20 变成 1。
仅从结构上看,若每层都采用同样的 356-byte global entry,则逐层保存需要:
CSA2 Decoder 只需要:
也就是 Decoder global cache 的 layer 维理论上减少约 20 倍。
这不是说整个模型 KV 一定恰好减少 20 倍,因为还存在:
- Encoder 的三份 global cache;
- 每层 SWA state;
- 不同基线的量化格式;
- scale 与 metadata。
但它说明了 ratio=1 仍然能有巨大收益的原因。
A.10.3 Main KV 是共享的,但 Query 不是共享的
所有 Decoder 层可以读取同一份 global memory:
但每层仍生成自己的 Query:
所以同一份 Main KV 可以被不同抽象层次的 Query 以不同方式解释。共享的是 memory bank,不是 attention computation。
A.10.4 主 Attention 不会读取全部 个位置
ratio=1 只是表示 global memory 每个 token 一个 entry,并不表示 core attention 是 dense attention。
每层真正读取的数量大约为:
因此昂贵的 64-head、512-dim core attention 成本近似与 无关。
随 增长的主要部分转移到了轻量低维 indexer,而不是主 attention。
A.10.5 20 层并不都运行 Indexer
Decoder 中:
- 1 个 Full 层运行全局 indexer;
- 4 个 Reindex 层更新 Top-K;
- 15 个 Reuse 层完全不运行 indexer。
即使不考虑 hierarchical candidate,索引次数也从“每层一次”降到:
再加入 candidate pool 后,大致变成:
而不是:
A.10.6 CED 让历史 token 不必穿过整个 Decoder
Decoder global KV 从 Encoder final hidden 生成,而不是从每个 Decoder 层自己的历史 hidden 生成。因此对绝大多数 prompt token:
- 计算 Encoder final hidden;
- 建立共享 Decoder global KV;
- 不需要让这些 token 再经过 20 层 Decoder。
只有最后 128 个 token 需要经过 Decoder,以重建每层局部 SWA state 并得到最后位置 logits。
A.10.7 为什么不进一步把 Decoder 也设成
报告没有把它明确写成唯一因果解释,但从结构上可以得到一个合理判断:
- Decoder 已通过 20 层共享一份 cache,大幅压缩 layer dimension;
- Decoder 的 global memory 直接服务最终生成,更需要精细的逐 token 可寻址性;
- Hierarchical Indexer 已将 core attention 控制在 Top-512;
- FP4 又显著降低了每个 entry 的存储成本。
因此选择 是一种“用 layer compression 换取 token-level retrieval precision”的设计:保留逐 token 精度,同时依靠跨层共享、稀疏访问和 FP4 控制成本。
A.11. Hierarchical Sparse Indexer
如果每个 Reindex 层仍扫描百万上下文,那么每次 indexer 仍是 。V4.1 因此只在 Decoder 中使用两级检索。
第一层 Full indexer 的 block score 为:
选择 2048 个 block,每块 8 个位置,得到最大 16,384 个 candidate。之后每个 Reindex 层使用自己的 Query 和 head weights,在候选池中独立选择 Top-512。
A.11.1 为什么 Candidate Pool 比 Top-K 大很多
如果 layer 20 只把自己的 Top-512 传给所有深层,那么浅层遗漏的位置永远无法恢复。
16K candidate pool 是一个中间召回集合:
- Full 层自己的 attention 仍只读取 Top-512;
- 后续 Reindex 可以在较大的 16K 集合里改变选择;
- 这样在减少搜索范围的同时保留跨层多样性。
A.11.2 它仍然不是严格 Decode
仍然需要:
- Decoder layer 20 扫描全部 ;
- Encoder layer 2、8、14 各扫描大约 ;
- 只是这些扫描在较小的 128 维 FP4 Indexer K 上进行;
- 真正昂贵的 512 维、64-head core attention 始终只处理固定 Top-K。
所以报告所说的 Decode FLOPs “nearly constant”不是数学上完全没有线性项,而是线性项已经缩小到整体计算中的较小部分。
A.12. CSA2 单层的完整张量流
V4.1 的关键维度:
- hidden dimension:5120;
- Main Query heads:64;
- Main head dimension:512;
- Query latent rank:1280;
- Indexer heads:32;
- Indexer head dimension:128;
- Top-K:512;
- SWA window:128。
对 batch size 、本轮 query 数 ,张量形状为:
这里 指单个 query 的局部可见窗口或持久 Decode ring;Prefill 的临时 SWA 投影张量可以覆盖整个 chunk,并非所有临时 buffer 都最多 128 项。完整 index-score 张量也是数值语义示意,生产 kernel 可分块计算而不物化它。
A.12.1 Partial RoPE 与 inverse RoPE
Main latent 同时充当 K 和 V。如果对其最后 64 维施加 RoPE,那么它作为 Value 被加权求和后,输出也携带绝对位置旋转。
因此对 attention output 再应用 query 位置的逆旋转:
来自位置 的贡献近似变成:
从而恢复相对位置信息。
A.13. CED:为什么 Prefill 能跳过大部分 Decoder
CED 中的 Encoder 仍然是 causal encoder,不是 BERT 式双向 Encoder。
下半 20 层对 prompt 的所有位置生成:
一般形式下,Decoder global KV 直接从 投影:
而不是从每个 Decoder 层自己的历史 hidden state 产生:
结合 V4.1 的 CSA2 schedule,实际只有 Decoder Full layer 20 创建 global cache,其余 19 层共享。
A.13.1 Prefill 数据流
普通 Decoder-only Transformer 的 Prefill 主体成本近似:
CED 的成本变为:
当 :
A.13.2 为什么早期 Prompt token 可以跳过 Decoder
未来 Decode 需要的 Decoder global KV 已经由 Encoder final hidden 产生。早期 prompt token 在 Decoder layer 21–39 的中间输出不会被保存为长期 global KV,也不会成为未来 token 的全局 Key/Value。
所以它们没有必要全部通过 Decoder。
但最近 token 的 Decoder hidden 仍然重要,因为每个 Decoder 层都有自己的 SWA KV。因此最后 128 个 token 必须顺序通过 Decoder,用来:
- 建立每层 Decoder SWA ring;
- 产生 prompt 最后位置的最终输出和 logits。
这意味着:
- Prefill 可以跳过绝大多数历史位置的 Decoder 计算;
- Decoder layers 之间仍然串行;
- 每个新 Decode token 仍需通过全部 40 层。
A.14. Decode 时的逐层数据流
具体过程:
- 新 token 经过全部 Causal Encoder layers;
- Encoder layer 2、8、14 是 ratio=2 的 Full source:
- 每两个 Decode step 产生一个 compressed entry;
- 尚未凑满两个 token 时保存在 compressor tail state;
- Encoder final hidden 到达 Decoder;
- layer 20 生成一个新的 ratio=1 Decoder Main KV 与 Indexer K;
- layer 20 扫描全部 Decoder Indexer K,产生 Top-512 与 candidate pool;
- layer 24/28/32/36 在 candidate pool 中重新选择;
- 每个 CSA2 层计算自己的 Main Q、SWA KV 和 attention output;
- token 顺序通过 40 层,因此 Decode 激活参数约为 16B/token。
A.15. 对应官方代码的简化实现
以下代码是为了突出控制流,不是可以直接加载官方 checkpoint 的完整实现。
A.15.1 CSA2 Compressor
1 | def compress(x, ratio, w_kv, w_gate=None): |
Decode 时 需要维护:
第二个 token 到达时才生成完整 latent,并追加到 global paged cache。
A.15.2 Indexer
1 | def run_indexer(query_x, query_latent, index_k, candidates=None): |
A.15.3 三种 Mode
1 | def csa2_layer(x, mode, shared): |
A.15.4 官方代码中的映射
官方 model.py 使用:
1 | self.is_kv_source = layer_id in kv_source_layers |
因此:
- 同时是 KV source 与 index source:Full;
- 不是 KV source、但是 index source:Reindex;
- 两者都不是:Reuse。
共享状态集中在:
1 | class SharedAttentionRuntime: |
物理 global cache 只在 KV source layer 分配;但每一层都拥有自己的:
1 | window_kv_cache # [batch, 128, 512] |
因此代码层面可以概括为:
Global cache 是 group-owned,SWA cache 是 layer-owned。
A.16. 为什么正好是 890 bytes/token
报告称 V4.1 的 global KV footprint 为:
这个数字可以从模型配置和 FP4 scale 格式推导出来。
A.16.1 一份 Main KV entry
Main KV dimension 为 512,FP4 payload:
Main KV 每 16 个值有一个 1-byte E4M3 scale:
因此:
A.16.2 一份 Indexer K
Indexer K dimension 为 128:
每 32 个值有一个 1-byte E8M0 scale:
因此:
一份 Main KV + Indexer K:
A.16.3 三个 Encoder source,ratio=2
Encoder KV source 为 layer 2、8、14:
A.16.4 一个 Decoder source,ratio=1
合计:
这里的 890 bytes 是随上下文长度线性增长的 global cache。每层 128-entry SWA ring 是固定大小 ,不随 继续增长。
A.17. KV Cache Manager 与持久化缓存
A.17.1 V4 的异构 KV cache
V4 同时存在:
- CSA Main KV;
- CSA Indexer K;
- HCA KV;
- 每层 SWA KV;
- CSA/HCA 尚未凑满 block 的 tail state。
由于 ,global paged block 需要兼容:
个原始 token 的对齐关系。
V4 将缓存分为两类。
Classical/Paged KV cache
存放已经完成压缩的:
- CSA Main KV;
- CSA Indexer K;
- HCA KV。
State cache
为每个 active sequence 分配固定 state block,保存:
- 每层最近 128 个 SWA KV;
- 尚未完成压缩的 KV/gate tail state。
SWA 和 compressor tail 更像“当前位置决定的 sequence state”,不适合直接套用普通 append-only PagedAttention 管理方式。
A.17.2 V4.1 按复用时间尺度分层
V4.1 将状态进一步划分为:
长期 Global KV
- 可以被大量后续 turn 复用;
- active 部分驻留 HBM;
- persistent copy 放在 SSD/host memory;
- 报告中的典型长期保留时间至少约 72 小时。
短期 Encoder SWA state
- 主要在分钟级活跃 session 内有价值;
- 不再长期写入 persistent SSD cache;
- 使用每台机器约 10% host DRAM 组成短 TTL 分布式池。
- 这里指可复用的 Encoder SWA;Decoder SWA 仅供当前 Decode 使用,不进入 prefix cache。
可重建 state
当 SWA state 淘汰后,通过 Bounded Replay 恢复,而不是一直存储。
其原则是:
不同状态拥有不同的生命周期、存储介质、淘汰策略和恢复成本。
A.18. SWA Bounded Replay
A.18.1 为什么精确恢复需要
虽然一层 SWA 只读取最近 个位置,但深层 token hidden 已经依赖浅层更早的局部历史。要精确重建所有层最后 个 SWA KV,需要逐层扩大 replay 范围,代价近似为:
个历史 token 位置。这里是依赖覆盖的历史跨度,不是总运算量;这些位置还需通过相应模型层,不能将其误写成仅有 个 token-layer 运算。
A.18.2 Encoder SWA Bounded Replay
当 global prefix cache 命中但 Encoder SWA 丢失时:
- 读取已经缓存的 global KV;
- 取命中 prefix 的最后 个 token;
- 将它们与 uncached suffix 一起重放;
- replayed prefix 只重建 SWA,不覆盖原有 global KV;
- uncached suffix 同时建立新的 global KV 和 SWA。
由于 replay 起点截断了更早的 SWA 依赖,所以恢复结果是近似的,并且可能依赖 cache-hit position。
A.18.3 Decoder SWA Bounded Replay
每次 Prefill 均需建立可用的 prompt 状态;下面先描述没有 prefix cache 命中的情况:
- 完整 prompt 通过 Causal Encoder;
- 从 Encoder outputs 建立 Decoder global KV;
- 只取最后 128 个 Encoder outputs;
- 让它们通过 Decoder;
- 生成所有 Decoder layers 接下来 Decode 所需的 SWA ring;
- 这些 Decoder SWA state 不进入长期 prefix cache。
这是 CED 能大幅减少 Prefill 主体 token-layer 工作量的系统前提。上述复杂度写法表达计算深度节省,不是包含 context-dependent indexing 的严格总 FLOPs 公式。若 prefix 命中,应改成复用已有 Global、处理 suffix 和必要 replay,而不是重新让完整 prompt 通过 Encoder。
A.19. 分布式训练与推理 Kernel
A.19.1 V4 的 Context Parallel Compressor 边界
Context Parallelism 按 sequence 维切分,每个 rank 保存连续 token。Compression block 可能跨 rank 边界,而且 packed samples 的尾部长度可能不足 。
V4 使用两阶段处理:
- rank 把末尾最多 个未压缩状态发送给 rank ;
- 下游 rank 将边界状态与本地 token 一起压缩;
- 各 rank 产生固定上限长度、允许 padding 的 compressed entries;
- All-Gather 收集所有 compressed entries;
- fused select-and-pad 将有效 entry 重排,并把 padding 放到尾部。
V4.1 Encoder ratio=2 时仍有类似的 compression boundary 问题,只是窗口更小。
A.19.2 CSA2 跨 Pipeline Stage 共享
Full source 与 Reuse/Reindex consumer 可能被放到不同 Pipeline Parallel stage,因此训练系统需要:
Shadow Indexers
- 在参与执行的 stage 放置轻量可执行副本;
- 只有一个 logical owner 负责优化器和 checkpoint;
- 同步参数并聚合梯度。
Pipeline Payload Extensions
跨 stage 传输:
- 共享表示;
- sparse routing information;
- Top-K/candidate 等状态。
这些状态需要和 Context Parallelism 使用一致的分片方式。
Microbatch-Level Shared-State Manager
状态必须按照 microbatch 独立追踪,并跨越:
- forward;
- activation recomputation;
- backward。
直到最后一个 consumer 完成才能释放,避免并发 microbatch 相互覆盖。
A.19.3 Sparse Attention Kernel
官方参考 TileLang kernel 展示了:
- 按 int32 indices 直接 gather KV;
- 每轮处理 64 个 sparse positions;
- 256 threads;
- FlashAttention 风格 online softmax;
- 维护 running maximum 与 running sum;
- 融合 learnable attention sink;
- 不要求预先物化一份 Selected-KV cache。
生产报告还列出:
- FlashMLA:融合 RoPE–Attention–inverse RoPE–cast;
- DeepGEMM:Mega-Gate、Mega-mHC、Mega-MoE;
- TileKernels;
- DeepSelect TopK。
Reuse layer 因为没有 compressor 和 indexer,报告称只需:
- Prefill:15 个 kernels;
- Decode:11 个 kernels。
A.19.4 EPD Disaggregation
系统采用 Encoder–Prefill–Decode disaggregation:
- Encoder deployment stage 主要处理多模态 vision encoding;
- Prefill stage 面向长序列和高吞吐;
- Decode stage 面向单 token 与低延迟。
三类资源可以独立扩缩容并重叠执行。这里部署语境中的 Encoder 不应与模型内部 20-layer Causal Encoder 完全混为一谈。
A.20. 公开参考代码与生产系统的区别
官方 README 明确说明公开实现是 readable reference implementation,而不是 production serving engine。
A.20.1 Hierarchical Indexer 的参考实现没有真正减少 GEMM 范围
论文中的生产语义是:Reindex 只计算 candidate positions。
公开 Python 代码为了可读性,先执行:
1 | index_score = einsum(q, full_index_k) |
再做:
1 | index_score.masked_fill_(~candidates, -inf) |
这样数值语义正确,但并没有在参考实现中省掉完整 score GEMM。生产系统必须先 compact/gather candidates,再运行 indexer,才能得到固定候选成本。
A.20.2 FP4 主要是数值模拟,不是完整 Packed Cache Manager
参考代码使用 in-place quantize/dequantize 模拟 FP4 QAT 数值,而 sparse-attention 接口仍然接收 BF16 tensor。它没有完整展示生产系统中的:
- packed FP4 payload;
- scale layout;
- paged allocation;
- HBM/DRAM/SSD transfer;
- prefix cache metadata。
A.20.3 Top-K 与共享运行时
参考实现使用 torch.topk;生产系统使用更高性能的 DeepSelect TopK kernel。
参考实现还使用进程级 shared_attn singleton,适合一次顺序 forward。Continuous batching 中必须按以下粒度管理:
- request/sequence;
- microbatch;
- Pipeline stage;
- speculative branch;
- cache hit/replay 状态。
否则一个 batch 的 Main KV、Top-K 或 candidate pool 可能覆盖另一个 batch 的状态。
A.21. 复杂度与收益总结
A.21.1 各机制对比
| 机制 | 长期 Global KV | Core Attention | Indexer |
|---|---|---|---|
| Dense MLA | entries | 无 | |
| DSA | 通常仍约 entries | 多层扫描 | |
| V4 CSA | 每层约 | CSA 层扫描 | |
| V4 HCA | 每层约 | 无 | |
| V4.1 CSA2 | 只在 4 个 KV source 保存 | 只在 8 个 source 执行;Decoder Reindex 使用 candidate pool |
A.21.2 一百万 token 的直观规模
当 :
Encoder 三个 source、ratio=2:
个 Main KV entry。
Decoder 一个 source、ratio=1:
个 Main KV entry。
合计为 份 source entries,而不是 38 个 CSA2 层各保存一份、形成 。
同时每层真正昂贵的 core attention 只读取约 640 个位置。
A.21.3 V4 与 V4.1 汇总
| 维度 | V4 CSA/HCA | V4.1 CSA2 |
|---|---|---|
| KV entry | shared-KV latent | shared-KV latent + FP4 |
| Sequence compression | CSA 4:1、HCA 128:1 | Encoder 2:1、Decoder 1:1 |
| Layer compression | 基本逐层独立 | 38 个 CSA2 层只有 4 个 KV source |
| Index reuse | 无系统性跨层复用 | Full/Reindex/Reuse |
| Reindex 搜索 | 全部 compressed positions | Decoder 后续层最多 16K candidates |
| HCA | 有 | 取消,纯 CSA2 |
| SWA | 每层 128 | 每层 128 |
| Persistent SWA | 存储、checkpoint 或精确重算 | 不长期存,Bounded Replay |
| Prefill | Prompt 经过完整模型 | 全 Prompt 走 Encoder,Decoder 只 replay 尾部 |
| Global KV precision | RoPE BF16、其余 FP8 | FP4 |
| V4.1 runtime global KV | — | 890 bytes/token,约为 V4-Flash 的 1/4 |
| V4.1 persistent KV | — | 约为 V4-Flash 的 1/8 |
A.22. 常见误解与局限
A.22.1 常见误解
-
CSA compression 不是量化。 它是多个 token 到一个 latent 的 learned pooling;FP4/FP8 才是数值量化。
-
CSA2 不是单纯的 token pooling。 最主要的新增收益是 layer-level KV 与 index reuse。
-
Reuse layer 不是跳层。 它仍执行自己的 Query、SWA、core attention、输出投影、MoE 和 residual/mHC。
-
Decoder ratio=1 不代表没有压缩。 它仍有 entry compression、20-to-1 layer sharing、FP4 和 sparse Top-K。
-
共享 KV 不代表 layers 可以并行。 下一层 Query 仍依赖上一层 hidden output。
-
Candidate pool 不是新的 KV cache。 它是一组位置或 block routing state,Main KV 仍是原来的共享 cache。
-
Hierarchical Indexer 不是完全消除 。 第一层 Full indexer 仍扫描完整上下文。
-
Prefill 跳过 Decoder 不等于 Decode 也跳过 Decoder。 每个新生成 token 仍然经过完整 40 层。
-
删除 compressor absolute bias 不等于删除 RoPE。 Main KV、Indexer K、Query 和 output 仍有位置处理。
-
公开 Python 代码不是生产 Serving Engine。 它主要用于表达 checkpoint 结构、张量关系和数值语义。
A.22.2 主要局限
压缩损失
Encoder ratio=2 仍然是有损 pooling。虽然 SWA 保存局部精确信息,但远距离信息只能通过压缩 latent 被访问。
Index selection error
Top-K 可能漏掉真正相关的位置。Candidate pool 也可能在第一层 Full indexer 阶段漏掉某个区域,后续 Reindex 无法跳出候选集恢复它。
Reused Top-K 可能变旧
Reuse layers 的 hidden abstraction 在变化,但访问位置不变。V4.1 每四个 Decoder 层插入一次 Reindex,是精度与成本之间的折中。
Bounded Replay 是近似状态恢复
恢复结果可能依赖 prefix cache 命中位置,在极端输入或 cache-resumption boundary 上存在潜在鲁棒性风险。技术报告也明确把它列为未来需要继续压力测试的边界。
系统实现复杂
Layer sharing 会显著增加:
- Pipeline Parallel 调度复杂度;
- microbatch shared-state 生命周期管理;
- continuous batching 的状态隔离要求;
- prefix cache、replay 与 speculative decoding 的组合状态空间。
A.23. 参考资料
技术报告
官方参考实现
- DeepSeek-V4-Pro inference code
- DeepSeek-V4.1-Flash inference code
- DeepSeek-V4.1 model.py
- DeepSeek-V4.1 kernel.py
- DeepSeek-V4.1 config.json
- DeepSeek-V4.1 reference implementation README
附录 B:完整性核对清单与来源
B.1 主题与位置对应
本表用于查找细节,不替代正文和附录中的完整解释。
| 之前讨论的主题 / 问题 | 本文位置 |
|---|---|
| 整体模型图、组件、Encoder–Decoder 关系 | 第 1–3 章,图 1 |
| Text/Vision Embedding、ViT、降采样、统一序列 | 第 2.1–2.2 节 |
| MoE 路由、多模态负载平衡 | 第 2.3 节 |
| Single-Pass mHC 原理与 activation 流量 | 第 2.4 节 |
| Engram、查表、预取、与请求 cache 的区别 | 第 2.5 节 |
| DSpark、置信度、验证长度和状态提交 | 第 2.6 节、第 17 章 |
| 40 层配置、四个 KV source、八个 index source | 第 3 章,图 2,附录 A.9 |
| CSA2 Full / Reindex / Reuse 原理 | 第 4 章,图 3,附录 A.8 |
| V4 CSA、HCA、MLA、DSA 的完整比较 | 附录 A.2–A.6、A.21 |
| Compressor 为何简化、单流/双流、重叠/非重叠 | 第 6.3 节,附录 A.3、A.7 |
| Decoder ratio=1 的收益 | 第 4.5 节,附录 A.10 |
| Hierarchical Indexer、候选池与 Top-K | 第 4.4 节,附录 A.11 |
| Query/KV 张量形状、Partial RoPE、输出投影 | 第 4–5 章,附录 A.12 |
| 为什么每层都有 SWA、窗口滑动原理 | 第 5.2–5.3 节 |
| Global 与 SWA 的来源、覆盖重叠、是否能去重 | 第 5.4–5.8 节 |
| Concatenation 轴、共享 softmax、物理 gather | 第 5.5–5.6 节 |
| ratio-2 完整 entries 与 compression tail | 第 6.1–6.2 节 |
| 、、 符号含义 | 第 6.5 节 |
| Encoder/Decoder Global pool 所有权 | 第 6.6 节、第 10 章 |
| 冷 Prefill 的所有阶段 | 第 7 章 |
| 为何不是只保留 128 个历史 token、窗口是否静态 | 第 7.5–7.6 节 |
| 每步 Decode、采样与 cache 写入时差 | 第 8 章 |
| YOCO 与 CED、位置数与层数的区别 | 第 9 章 |
| Runtime / Prefix / Persistent cache 的区别 | 第 10 章 |
| Decoder SWA 不做 prefix caching 的准确含义 | 第 10.1–10.5 节 |
| 890 bytes/token、SWA 固定容量、FP4 数值格式 | 第 10.6–10.7 节,附录 A.16 |
| Cache hit、Encoder SWA miss 与恢复流程 | 第 11 章 |
| 近似 replay、跨层依赖、 单位纠正 | 第 11.4 节,附录 A.18 |
| 两个 replay 边界、4100/4096/128 例子 | 第 12 章,图 4 |
| EPD/PD 与模型层切分的区别 | 第 13 章 |
| P→D 全量/增量交接、tail、SWA、metadata | 第 14 章 |
| 请求间流水线、chunk 计算传输重叠 | 第 15 章 |
| TTFT、首个 ITL、稳态 ITL | 第 16 章 |
| Speculation 的 Global/SWA/tail 回滚 | 第 17.3–17.4 节 |
| 容量不等于 HBM 流量、调度成本与可研究方向 | 第 18 章 |
| 完整模型控制流示意、官方代码阅读方法 | 第 19 章 |
| 原 compressor/indexer/mode 伪代码 | 附录 A.15 |
| 分布式训练、CP 边界、shadow indexers、kernel | 第 19.6–19.7 节,附录 A.19 |
| 参考代码与生产系统差别、局限与误解 | 第 19.5 节、第 20 章,附录 A.20–A.22 |
B.2 四张图片的保存与出处说明
四张用户附件均以原文件复制保存,不裁剪、不重绘、不降低分辨率。正文采用原图资源,方便把说明与对应模块逐一对照。
| 本文图号 | 用户附件顺序 | 文件名 | 用途 |
|---|---|---|---|
| 图 1 | 1 | 01-overall-architecture.png |
整体模型架构 |
| 图 2 | 3 | 03-four-block-types.png |
四类 Attention block 与来源关系 |
| 图 3 | 2 | 02-csa2-modes.png |
Full/Reindex/Reuse 组件图 |
| 图 4 | 4 | 04-two-replay-boundaries.png |
两种 replay 的边界示意 |
图 1、图 3 对应技术报告中的整体架构和 CSA2 模式图;图 2、图 4 是用户提供的解释图。图 2 的原脚注提到本地代码,不代表本文重新把本地实现作为官方生产系统证据;本文具体层布局以官方配置核对。图 4 的数值例子仅用于机制解释,不作为新实验结果。
Markdown 中图片引用的是当前工作区的持久资源目录,不依赖临时剪贴板文件。若将文档移动到其他电脑,需要一起复制该资源目录,并相应调整图片路径。
B.3 原文档保留与编辑性校正
图源完整性补充核对
上一次整理遗漏了后续整体架构讲解的五张 Mermaid 图,不能用“旧专题的图都保留了”代替对全部讨论图示的检查。本次从该次讲解的原始内容恢复以下五张图源,节点和连线不以摘要替代:
| 恢复的图 | 正文位置 | 图中完整保留的关系 |
|---|---|---|
| 图 1A:EPD 部署与状态通路 | 第 1.4 节 | 请求入口、视觉服务、P/D、长期 Global、短期 Encoder SWA、Engram 和回写 |
| 图 3A:Decoder 共享关系 | 第 4.4 节 | L20 memory、Full Top-K、query-local candidate、四个 Reindex 与各组 Reuse |
| 图 5:冷 Prefill 状态流 | 第 7.1 节 | 全序列 Encoder、三份 Encoder Global、局部状态/尾部、Decoder Global 和尾窗 |
| 图 6:请求级流水线 | 第 15.1 节 | A 的交接与生成、B 的输入/Prefill、并发分支和 batch 接入 |
| 图 7:单请求分块流水线 | 第 15.2 节 | chunk 计算、Global blocks 传输、最终 replay、状态交接和 ready |
你指出的截图对应图 3A。本次保留其原始 Mermaid 图源,未用一段文字或一张简化表替代该图。
附录 A 原有的十二张 Mermaid 图也全部保留,位置如下:
| 附录位置 | 图示内容 |
|---|---|
| A.3.1 | V4 CSA 的完整数据流 |
| A.4 | V4 HCA 的完整数据流 |
| A.7.1 | V4 CSA 双流重叠压缩 |
| A.7.2 | CSA2 单流非重叠压缩 |
| A.8.1 | Full / Reindex / Reuse 三种模式 |
| A.8.2 | Main KV、Indexer K、Top-K 三条共享状态通路 |
| A.8.3 | L24–L27 的 source 与 consumer |
| A.9 | 四十层模型布局 |
| A.11 | Hierarchical Sparse Indexer |
| A.12 | CSA2 单层张量流 |
| A.13.1 | CED Prefill 数据流 |
| A.14 | Decode 逐层数据流 |
总计:正文四张附件图片、五张恢复的 Mermaid 图,附录十二张 Mermaid 图。Mermaid 继续使用原生代码块,由支持 Mermaid 的阅读器显示;按本次要求,不另外生成 PNG/SVG 图片副本。
文本与原文件保留
原文件 DeepSeek-V4_CSA-HCA与V4.1-CSA2详解.md 保持不变。新文档附录保留其全部实质章节,另作以下澄清:
- 将“列出五项收益却称四项”的数量笔误统一为五项。
- 将精确 replay 的历史跨度与 token-layer 工作量分开。
- 将 Prefill 临时张量长度与持久 SWA ring 容量分开。
- 将冷 Prefill 的全序列 Encoder 计算,与 prefix-hit 情况下的复用/恢复分开。
- 将 Encoder 短期 SWA 复用,与 Decoder SWA 不进入 prefix cache 分开。
- 为教学公式和代码补充因果 mask、边界状态、source 所有权与生产实现差异的说明。
这种校正是为了保留讨论内容的同时消除歧义,不把前面不够严谨的简写当成模型事实继续传播。
B.4 一手来源与阅读路径
- DeepSeek-V4.1 Flash 技术报告:重点阅读 §2 Architecture、§3.1 Training Infrastructure、§3.2 Inference System、§4.2.1 Model Setups。本文的整体组件、replay 和持久化策略主要来自这些部分。
- DeepSeek-V4 技术报告:用于理解 CSA/HCA、压缩路径和先前状态管理的背景,不能把 V4 的参数直接套用到 V4.1。
- V4.1 官方模型配置:确认层号、source 列表、dimension、window size、候选池和视觉配置。
- V4.1 官方 model.py:阅读投影、source/consumer、局部窗口、共享 runtime、Engram 与 DSpark 的模型语义。
- V4.1 官方 kernel.py:理解稀疏 gather、online softmax、量化与实现表达。
- V4.1 inference README:确认参考实现的定位和运行条件,不将其等同于生产 serving engine。
- YOCO 论文:用于理解共享上层记忆为何允许跳过历史 query 的上层 Prefill;V4.1 加入逐层局部状态后,应单独考虑 bounded replay。
最终边界提醒: 模型计算图能确定数据依赖和必要状态,但不能唯一确定服务器部署、网络协议、缓存分配器、replay 放置或 speculative rollback 实现。本文对这些部分均按工程分析表述,而非将推导冒充官方已公开实现。
- 标题: 万字长文解析DeekSeekV4.1flash
- 作者: 鱿鱼圈
- 创建于 : 2026-09-20 19:10:00
- 更新于 : 2026-10-05 13:10:45
- 链接: https://yuyanqi.com/2026/09/20/万字长文解析DeekSeekV4.1flash/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。